نویسنده: reza_pmh

  • تفاوت ذخیره‌سازی On-Premises و Cloud Storage

    تفاوت ذخیره‌سازی On-Premises و Cloud Storage

    در عصر دیجیتال امروز، داده‌ها به عنوان ارزشمندترین دارایی سازمان‌ها شناخته می‌شوند. با رشد روزافزون حجم داده‌ها، انتخاب راهکار مناسب برای ذخیره‌سازی، یک تصمیم استراتژیک و حیاتی برای هر کسب‌وکار است. دو رویکرد اصلی در این زمینه وجود دارد: ذخیره‌سازی محلی یا On-Premises و ذخیره‌سازی ابری یا Cloud Storage. هر یک از این مدل‌ها، مزایا و معایب خاص خود را دارند و شناخت دقیق تفاوت‌های آن‌ها، به شما کمک می‌کند تا بهترین گزینه را برای نیازهای کسب‌وکار خود انتخاب کنید.

    این محتوای جامع، به صورت عمیق به مقایسه این دو مدل ذخیره‌سازی از جنبه‌های مختلفی مانند هزینه، امنیت، مدیریت، و مقیاس‌پذیری می‌پردازد و به شما کمک می‌کند تا یک تصمیم آگاهانه بگیرید.

    ذخیره‌سازی On-Premises چیست؟

    ذخیره‌سازی On-Premises به معنای نگهداری داده‌ها و مدیریت زیرساخت ذخیره‌سازی در داخل محیط فیزیکی و شبکه سازمان است. در این مدل، سازمان تمامی سخت‌افزارهای لازم، مانند سرورها، آرایه‌های ذخیره‌سازی (SAN/NAS) و سیستم‌های بکاپ را خریداری، نصب و نگهداری می‌کند. داده‌ها به صورت کامل تحت کنترل سازمان هستند و دسترسی به آن‌ها از طریق شبکه داخلی صورت می‌گیرد.

    اجزای اصلی یک زیرساخت ذخیره‌سازی محلی شامل چندین جزء کلیدی است: سخت‌افزار ذخیره‌سازی که شامل سرورها، هارد دیسک‌ها و آرایه‌های SAN و NAS است، نرم‌افزارهای مدیریتی برای پیکربندی و نظارت بر عملکرد، یک شبکه داخلی پرسرعت و در نهایت یک تیم IT متخصص برای نصب، نگهداری و عیب‌یابی زیرساخت. تمامی این اجزا در کنار هم یک سیستم یکپارچه را تشکیل می‌دهند که کاملاً تحت کنترل سازمان است.

    ذخیره‌سازی محلی به دلیل کنترل کامل بر داده‌ها، برای بسیاری از سازمان‌ها جذاب است، اما چالش‌های خاص خود را نیز دارد. مزیت اصلی آن، کنترل کامل و بی‌قید و شرط بر داده‌هاست که برای سازمان‌هایی با داده‌های بسیار حساس حیاتی است. همچنین، دسترسی به داده‌ها از طریق شبکه داخلی، تأخیر (Latency) بسیار پایینی دارد که برای برنامه‌های حیاتی و حساس به زمان ضروری است. علاوه بر این، برای سازمان‌هایی که مشمول قوانین سختگیرانه برای نگهداری داده‌ها در داخل کشور هستند، این راهکار ایده‌آل است.

    با این حال، این مدل با معایبی نیز همراه است. هزینه اولیه برای خرید سخت‌افزار و نرم‌افزار بسیار بالا است و مسئولیت کامل مدیریت و نگهداری زیرساخت نیز بر عهده تیم داخلی است. همچنین، مقیاس‌پذیری آن محدود و زمان‌بر است، زیرا برای افزایش ظرفیت باید سخت‌افزارهای جدیدی خریداری و نصب شوند. از طرفی، زیرساخت محلی در برابر بلایای طبیعی مانند زلزله و سیل آسیب‌پذیر است، مگر اینکه تدابیر امنیتی خاصی برای آن در نظر گرفته شود.


    Cloud Storage چیست؟

    Cloud Storage به معنای ذخیره‌سازی داده‌ها بر روی سرورهای ارائه‌دهندگان خدمات ابری (مانند AWS, Google Cloud, Microsoft Azure) است. در این مدل، سازمان به جای خرید و نگهداری زیرساخت فیزیکی، فضایی را از یک ارائه‌دهنده ابری اجاره می‌کند و داده‌های خود را از طریق اینترنت به آن منتقل می‌کند. تمامی مسئولیت‌های مربوط به نگهداری سخت‌افزار، مدیریت شبکه و امنیت فیزیکی بر عهده ارائه‌دهنده خدمات ابری است.

    یک زیرساخت ذخیره‌سازی ابری از اجزای زیر تشکیل شده است: ارائه‌دهنده خدمات ابری که زیرساخت ذخیره‌سازی را فراهم می‌کند، فضای ذخیره‌سازی که سازمان از آن اجاره می‌کند و در نهایت شبکه اینترنت که برای دسترسی به داده‌ها حیاتی است. این مدل به سازمان‌ها امکان می‌دهد تا به جای مدیریت زیرساخت، بر روی فعالیت‌های اصلی کسب‌وکار خود تمرکز کنند.

    ذخیره‌سازی ابری به دلیل انعطاف‌پذیری و کاهش هزینه‌های اولیه، به سرعت در حال محبوب شدن است. مزیت اصلی آن، هزینه اولیه پایین است، چرا که نیازی به سرمایه‌گذاری در سخت‌افزار نیست. همچنین، مقیاس‌پذیری آن نامحدود و فوری است؛ شما می‌توانید در عرض چند دقیقه، ظرفیت ذخیره‌سازی خود را افزایش یا کاهش دهید. این مدل برای استارت‌آپ‌ها و کسب‌وکارهای در حال رشد بسیار جذاب است.

    با این حال، این مدل نیز با معایبی همراه است. سازمان کنترل کمتری بر داده‌ها و زیرساخت خود دارد و امنیت داده‌ها به سیاست‌ها و اقدامات امنیتی ارائه‌دهنده خدمات ابری بستگی دارد. همچنین، دسترسی به داده‌ها از طریق اینترنت صورت می‌گیرد که ممکن است باعث تأخیر (Latency) شود. در نهایت، در صورت استفاده زیاد، هزینه‌های بلندمدت ابری می‌تواند از هزینه یک زیرساخت محلی بیشتر شود.


    مقایسه جامع On-Premises و Cloud Storage

    ویژگی

    ذخیره‌سازی On-Premises

    ذخیره‌سازی Cloud

    محل فیزیکی

    در داخل سازمان

    در دیتاسنترهای ارائه‌دهنده ابری

    هزینه اولیه

    بالا

    پایین

    مدل پرداخت

    سرمایه‌گذاری (CAPEX)

    عملیاتی (OPEX)

    مالکیت

    سازمان

    ارائه‌دهنده ابری

    کنترل داده‌ها

    کامل و بی‌قید و شرط

    وابسته به ارائه‌دهنده

    مقیاس‌پذیری

    محدود و زمان‌بر

    نامحدود و فوری

    مدیریت

    مسئولیت کامل با سازمان

    مسئولیت با ارائه‌دهنده ابری

    عملکرد

    بالا و با تأخیر کم

    وابسته به سرعت اینترنت و تأخیر بالا

    انطباق با قوانین

    آسان‌تر

    وابسته به قوانین و محل دیتاسنتر

    بازیابی از فاجعه

    نیازمند برنامه‌ریزی داخلی

    به صورت خودکار توسط ارائه‌دهنده


    ملاحظات کلیدی در انتخاب راهکار ذخیره‌سازی

    انتخاب بین On-Premises و Cloud Storage یک تصمیم پیچیده است که باید با در نظر گرفتن عوامل متعددی انجام شود.

    1. هزینه؛ سرمایه‌گذاری در مقابل پرداخت عملیاتی

    مهم‌ترین عامل در انتخاب، مدل مالی است. در مدل On-Premises، سازمان یک سرمایه‌گذاری اولیه (CAPEX) بزرگ برای خرید تجهیزات انجام می‌دهد. این مدل برای سازمان‌هایی مناسب است که بودجه کافی برای خرید سخت‌افزار را دارند و به دنبال کاهش هزینه‌های بلندمدت در صورت استفاده زیاد هستند. در مقابل، مدل Cloud Storage بر اساس پرداخت عملیاتی (OPEX) است، به این معنی که سازمان فقط برای منابعی که استفاده می‌کند، هزینه می‌پردازد. این مدل برای استارت‌آپ‌ها و کسب‌وکارهایی که به دنبال کاهش هزینه‌های اولیه هستند، بسیار جذاب است. با این حال، باید توجه داشت که در مقیاس‌های بزرگ، هزینه‌های بلندمدت ابری می‌تواند از هزینه نگهداری یک زیرساخت محلی بیشتر شود.

    2. امنیت و انطباق با قوانین

    امنیت داده‌ها یک نگرانی اصلی برای هر سازمان است. در مدل On-Premises، سازمان کنترل کاملی بر امنیت فیزیکی و منطقی داده‌ها دارد. با این حال، مسئولیت کامل حفاظت از داده‌ها در برابر تهدیدات سایبری و بلایای طبیعی نیز بر عهده خود سازمان است. در مدل Cloud Storage، مسئولیت امنیتی مشترک بین سازمان و ارائه‌دهنده ابری است. ارائه‌دهندگان ابری سرمایه‌گذاری عظیمی در امنیت فیزیکی و سایبری می‌کنند، اما سازمان نیز باید مسئولیت حفاظت از داده‌های خود را در داخل ابر (مثلاً با رمزنگاری) بر عهده بگیرد.

    3. عملکرد و تأخیر

    عملکرد یک عامل حیاتی برای برنامه‌های کاربردی است. در مدل On-Premises، داده‌ها در شبکه داخلی سازمان نگهداری می‌شوند که تأخیر بسیار پایینی دارد. این ویژگی برای برنامه‌هایی مانند پایگاه‌های داده‌های تراکنشی و پردازش‌های حساس به زمان حیاتی است. در مقابل، عملکرد Cloud Storage به سرعت و پایداری اتصال اینترنتی وابسته است. این تأخیر برای بسیاری از کاربردها قابل قبول است، اما برای برنامه‌هایی که نیاز به دسترسی لحظه‌ای دارند، ممکن است مشکل‌ساز باشد.

    4. مقیاس‌پذیری و انعطاف‌پذیری

    Cloud Storage برتری چشمگیری در زمینه مقیاس‌پذیری و انعطاف‌پذیری دارد. شما می‌توانید در عرض چند دقیقه، ظرفیت ذخیره‌سازی خود را از چند گیگابایت به پتابایت افزایش دهید. این انعطاف‌پذیری به سازمان‌ها امکان می‌دهد تا به سرعت به نیازهای بازار پاسخ دهند. در مقابل، مقیاس‌پذیری در زیرساخت On-Premises زمان‌بر و پرهزینه است و به خرید و نصب سخت‌افزار جدید نیاز دارد.


    راه‌حل‌های ترکیبی (Hybrid)؛ بهره‌گیری از مزایای هر دو مدل

    بسیاری از سازمان‌ها برای بهره‌گیری از مزایای هر دو مدل، از یک راهکار ذخیره‌سازی ترکیبی (Hybrid Storage) استفاده می‌کنند. در این مدل، داده‌های حیاتی و حساس که به عملکرد بالا و امنیت قوی نیاز دارند، در زیرساخت On-Premises نگهداری می‌شوند. همزمان، داده‌های کمتر حساس، داده‌های آرشیوی و بکاپ‌ها به Cloud Storage منتقل می‌شوند.

    مزایای این رویکرد بسیار زیاد است. اولاً، بهینه‌سازی هزینه را به همراه دارد، چرا که هزینه ذخیره‌سازی داده‌های آرشیوی در ابر بسیار کمتر از نگهداری آن‌ها در زیرساخت محلی است. دوماً، ابر می‌تواند به عنوان یک سایت Disaster Recovery برای داده‌های محلی عمل کند، که این امر پایداری و در دسترس بودن داده‌ها را به شدت افزایش می‌دهد. سوماً، این مدل به سازمان‌ها اجازه می‌دهد تا به راحتی منابع خود را بر اساس نیاز بین دو محیط جابجا کنند و از حداکثر انعطاف‌پذیری برخوردار باشند.

    در یک محیط ترکیبی، می‌توان با استفاده از ابزارهای مدیریتی پیشرفته، یکپارچگی بین زیرساخت محلی و ابری را حفظ کرد. این ابزارها امکان مدیریت یکپارچه داده‌ها را فراهم می‌کنند و اطمینان می‌دهند که داده‌ها به صورت صحیح و امن بین دو محیط جابجا می‌شوند. این مدل به سازمان‌ها اجازه می‌دهد تا کنترل کامل بر داده‌های حیاتی خود داشته باشند و همزمان از مزایای مقیاس‌پذیری و سهولت مدیریت در ابر نیز بهره ببرند.


    چالش‌های مهاجرت به Cloud Storage

    مهاجرت داده‌ها از یک زیرساخت On-Premises به Cloud Storage یک فرآیند پیچیده و چالش‌برانگیز است که نیازمند برنامه‌ریزی دقیق است. یکی از بزرگ‌ترین چالش‌ها، حجم داده‌ها و سرعت انتقال آن‌هاست. انتقال پتابایت‌ها داده از طریق اینترنت می‌تواند زمان‌بر و پرهزینه باشد و نیازمند پهنای باند بسیار بالا است. در برخی موارد، سازمان‌ها از راه‌حل‌های فیزیکی مانند انتقال هارد دیسک‌ها به دیتاسنتر ارائه‌دهنده ابری استفاده می‌کنند.

    چالش دیگر، امنیت داده‌ها در حین مهاجرت است. داده‌ها در حین انتقال باید به صورت کامل رمزنگاری شوند تا از شنود و دسترسی غیرمجاز جلوگیری شود. همچنین، سازگاری فرمت داده‌ها و برنامه‌های کاربردی با زیرساخت ابری نیز باید از قبل بررسی شود. یک برنامه‌ریزی دقیق برای تست و تأیید داده‌ها پس از مهاجرت نیز ضروری است تا از صحت و یکپارچگی آن‌ها اطمینان حاصل شود.

    علاوه بر این، انتخاب ارائه‌دهنده ابری مناسب نیز یک تصمیم حیاتی است. سازمان باید ارائه‌دهنده‌ای را انتخاب کند که از نظر امنیت، قابلیت اطمینان و قیمت، با نیازهای آن سازگار باشد. همچنین، باید از قوانین مربوط به نگهداری داده‌ها در کشورهای مختلف آگاه بود، چرا که برخی از قوانین ممکن است سازمان را ملزم به نگهداری داده‌ها در داخل کشور کنند.

    مدیریت داده‌ها در محیط‌های ذخیره‌سازی ترکیبی

    مدیریت داده‌ها در یک محیط ترکیبی نیازمند یک رویکرد جامع و ابزارهای پیشرفته است. یکی از مهم‌ترین جنبه‌ها، تعیین سیاست‌هایی برای جابجایی داده‌ها بین زیرساخت محلی و ابری است. این سیاست‌ها باید بر اساس فاکتورهایی مانند دسترسی‌پذیری داده‌ها، اهمیت و هزینه، تعیین شوند. برای مثال، داده‌های پرکاربرد می‌توانند در زیرساخت محلی نگهداری شوند، در حالی که داده‌های قدیمی و کمتر استفاده شده به صورت خودکار به فضای ذخیره‌سازی ابری منتقل می‌شوند.

    استفاده از ابزارهای خودکارسازی و هوش مصنوعی نیز می‌تواند به مدیریت بهینه داده‌ها در محیط ترکیبی کمک کند. این ابزارها می‌توانند به صورت خودکار داده‌ها را بر اساس سیاست‌های از پیش تعریف شده، بین محیط‌ها جابجا کنند و بهینه‌سازی هزینه را به همراه داشته باشند. همچنین، مدیریت امنیت در این محیط‌ها نیازمند یک رویکرد یکپارچه است که شامل مدیریت هویت و دسترسی در هر دو محیط و نظارت مداوم بر ترافیک شبکه باشد.

    در نهایت، مدیریت داده‌ها در محیط ترکیبی به مدیران IT اجازه می‌دهد تا منابع خود را به بهترین شکل ممکن تخصیص دهند. آن‌ها می‌توانند از مزایای کنترل کامل در محیط محلی و از مزایای مقیاس‌پذیری و سهولت مدیریت در محیط ابری بهره ببرند و بهینه‌سازی عملکرد و هزینه را در یکجا داشته باشند.

    آینده ذخیره‌سازی: از ابر تا لبه (Edge)

    آینده ذخیره‌سازی به سمت یک معماری غیرمتمرکز و ترکیبی در حال حرکت است. با گسترش اینترنت اشیاء (IoT) و نیاز به پردازش داده‌ها در لحظه، مفهوم ذخیره‌سازی لبه (Edge Storage) اهمیت فزاینده‌ای پیدا کرده است. در این مدل، داده‌ها به جای ارسال به یک دیتاسنتر مرکزی یا ابر، در نزدیکی محل تولید آن‌ها (مانند یک کارخانه هوشمند یا یک خودروی خودران) ذخیره و پردازش می‌شوند. این امر به کاهش تأخیر و بهبود عملکرد در برنامه‌های حساس به زمان کمک می‌کند.

    همزیستی ذخیره‌سازی محلی، ابری و لبه، یک معماری پیچیده اما قدرتمند را ایجاد می‌کند. داده‌های حیاتی و حساس به تأخیر در لبه پردازش می‌شوند، داده‌های مهم‌تر برای تحلیل در دیتاسنتر محلی ذخیره می‌شوند و داده‌های آرشیوی به فضای ذخیره‌سازی ابری منتقل می‌شوند. این معماری به سازمان‌ها اجازه می‌دهد تا از مزایای تمامی مدل‌ها بهره ببرند و یک زیرساخت ذخیره‌سازی واقعاً انعطاف‌پذیر و مقیاس‌پذیر را طراحی کنند که پاسخگوی نیازهای پیچیده آینده باشد.

    در نهایت، تصمیم‌گیری در مورد آینده ذخیره‌سازی به یک انتخاب بین دو مدل On-Premises و Cloud محدود نمی‌شود، بلکه به یک استراتژی جامع برای مدیریت داده‌ها در یک محیط چندگانه و ترکیبی تبدیل می‌شود. سازمان‌هایی که این واقعیت را درک کرده و زیرساخت خود را بر اساس آن طراحی می‌کنند، در نبرد رقابتی آینده موفق خواهند شد.

    نتیجه‌گیری

    ذخیره‌سازی On-Premises و Cloud Storage هر دو راهکارهای قدرتمندی برای مدیریت داده‌ها هستند، اما هر یک برای سناریوهای متفاوتی مناسب‌اند. On-Premises کنترل، عملکرد و امنیت بالایی را فراهم می‌کند، اما با هزینه و پیچیدگی همراه است. Cloud Storage انعطاف‌پذیری، مقیاس‌پذیری و سهولت مدیریت را ارائه می‌دهد، اما با کنترل و عملکرد کمتری همراه است. بهترین راهکار برای بسیاری از سازمان‌ها، استفاده از یک مدل ترکیبی است که از مزایای هر دو مدل برای ایجاد یک استراتژی ذخیره‌سازی قوی، کارآمد و مقرون‌به‌صرفه بهره می‌برد. در نهایت، با درک عمیق تفاوت‌ها و نیازهای خود، می‌توانید یک تصمیم استراتژیک بگیرید که آینده داده‌های شما را تضمین کند.

    سوالات متداول 

    1. آیا ذخیره‌سازی ابری برای تمامی سازمان‌ها مناسب است؟
      خیر. اگرچه ذخیره‌سازی ابری مزایای زیادی از جمله مقیاس‌پذیری و هزینه اولیه پایین دارد، اما برای تمامی سازمان‌ها مناسب نیست. سازمان‌هایی که با داده‌های بسیار حساس سروکار دارند یا مشمول قوانین سختگیرانه برای نگهداری داده‌ها در داخل کشور هستند، ممکن است به دلیل نیاز به کنترل کامل بر داده‌ها، ذخیره‌سازی On-Premises را ترجیح دهند.

    2. آیا امنیت داده‌ها در ابر از امنیت در زیرساخت محلی کمتر است؟
      امنیت در ابر لزوماً کمتر از زیرساخت محلی نیست. ارائه‌دهندگان بزرگ ابری سرمایه‌گذاری‌های عظیمی در امنیت فیزیکی و سایبری می‌کنند که ممکن است از توان یک سازمان عادی خارج باشد. با این حال، مسئولیت امنیتی یک مدل مشترک است. ارائه‌دهنده ابری مسئول امنیت زیرساخت است، اما سازمان مسئول امنیت داده‌های خود در داخل ابر (مثلاً با رمزنگاری و مدیریت دسترسی) است.

    3. بهترین راهکار برای انتقال داده‌های حجیم از زیرساخت محلی به ابر چیست؟
      انتقال داده‌های حجیم از طریق اینترنت می‌تواند زمان‌بر و پرهزینه باشد. برای این کار، ارائه‌دهندگان ابری راه‌حل‌های فیزیکی ارائه می‌دهند. برای مثال، سرویس AWS Snowball به شما اجازه می‌دهد داده‌های خود را روی یک دستگاه فیزیکی منتقل کرده و سپس آن دستگاه را برای آپلود به آمازون بفرستید. این روش به شکل چشمگیری در زمان و هزینه انتقال صرفه‌جویی می‌کند.

    4. آیا راهکار ترکیبی (Hybrid) می‌تواند بهترین انتخاب باشد؟
      برای بسیاری از سازمان‌ها، بله. راهکار Hybrid Storage به شما اجازه می‌دهد تا داده‌های حیاتی و با عملکرد بالا را به صورت محلی نگهداری کنید و همزمان از مزایای مقیاس‌پذیری و هزینه پایین ابر برای ذخیره‌سازی داده‌های آرشیوی و بکاپ‌ها بهره ببرید. این مدل، انعطاف‌پذیری لازم را برای سازگاری با نیازهای متغیر کسب‌وکار فراهم می‌کند.


  • مفهوم High Availability) HA) در ذخیره‌سازها

    مفهوم High Availability) HA) در ذخیره‌سازها

    در دنیای مدرن امروز که داده‌ها به عنوان ارزشمندترین دارایی سازمان‌ها شناخته می‌شوند، در دسترس بودن دائمی و بدون وقفه آن‌ها یک ضرورت حیاتی است. هرگونه توقف (Downtime) در سیستم‌های ذخیره‌سازی می‌تواند منجر به خسارات مالی، از دست رفتن اعتماد مشتریان و اختلال در عملیات تجاری شود. اینجاست که مفهوم High Availability) HA) یا قابلیت دسترسی بالا وارد میدان می‌شود. HA مجموعه‌ای از تکنیک‌ها، فرآیندها و طراحی‌های معماری است که با هدف به حداقل رساندن زمان از کارافتادگی و تضمین تداوم عملیات در سیستم‌های ذخیره‌سازی داده، پیاده‌سازی می‌شود.

    این محتوای جامع، به شما کمک می‌کند تا به صورت کامل با مفهوم HA، دلایل اهمیت آن، اجزای کلیدی یک معماری HA و بهترین روش‌های پیاده‌سازی آن در محیط‌های ذخیره‌سازی مدرن آشنا شوید.

    High Availability چیست؟ فراتر از فقط کار کردن

    High Availability یا قابلیت دسترسی بالا، به توانایی یک سیستم یا سرویس برای ادامه فعالیت و در دسترس بودن حتی در صورت بروز خرابی در یکی از اجزای آن اشاره دارد. در مورد ذخیره‌سازها، HA به معنای تضمین دسترسی به داده‌ها در هر شرایطی است. هدف اصلی HA، به حداقل رساندن زمان از کارافتادگی (Downtime) و نزدیک کردن آن به صفر است. این امر به سازمان‌ها امکان می‌دهد تا به صورت ۲۴ ساعته و ۷ روز هفته به فعالیت خود ادامه دهند و به تعهدات خود نسبت به مشتریان عمل کنند.

    برای درک بهتر HA، باید با مفاهیم کلیدی آن آشنا شد. زمان از کارافتادگی (Downtime) مدت زمانی است که یک سیستم یا سرویس به دلیل خرابی، از دسترس خارج می‌شود و زمان کارکرد (Uptime) مدت زمانی است که سیستم به صورت فعال و بدون وقفه کار می‌کند. HA به دنبال افزایش Uptime و کاهش Downtime است. همچنین، مفهوم نقطه خرابی واحد (Single Point of Failure) به هر جزئی در سیستم اشاره دارد که خرابی آن می‌تواند باعث از کارافتادگی کل سیستم شود. معماری HA به دنبال حذف این نقاط است تا سیستم در برابر خرابی‌های احتمالی مقاوم باشد.

    در نهایت، مهم‌ترین مفهوم در HA، افزونگی (Redundancy) است. افزونگی به معنای استفاده از اجزای اضافی برای جایگزینی اجزای خراب در صورت بروز مشکل است. این اجزا می‌توانند شامل سخت‌افزار، نرم‌افزار و یا حتی شبکه‌های جایگزین باشند. با پیاده‌سازی افزونگی، سیستم می‌تواند به صورت خودکار به اجزای جایگزین سوئیچ کند و از توقف عملیات جلوگیری کند. این مکانیزم، ستون فقرات هر معماری HA است.

    اهمیت High Availability در ذخیره‌سازها

    قابلیت دسترسی بالا در سیستم‌های ذخیره‌سازی، دیگر یک مزیت رقابتی نیست، بلکه یک ضرورت تجاری است. در دنیایی که هر ثانیه از کارافتادگی می‌تواند هزاران دلار هزینه به همراه داشته باشد، تضمین دسترسی دائمی به داده‌ها حیاتی است. این اهمیت از سه جنبه کلیدی قابل بررسی است.

    اولین و مهم‌ترین جنبه، تداوم کسب‌وکار (Business Continuity) است. هرگونه توقف در دسترسی به داده‌ها، می‌تواند منجر به توقف عملیات تجاری، از دست رفتن فروش و کاهش بهره‌وری شود. HA با تضمین در دسترس بودن داده‌ها، به سازمان‌ها امکان می‌دهد تا به صورت ۲۴ ساعته و ۷ روز هفته به فعالیت خود ادامه دهند و در نتیجه، از خسارات مالی و اعتباری جلوگیری کنند. این امر به ویژه برای صنایعی مانند مالی، تجارت الکترونیک و مراقبت‌های بهداشتی که به داده‌ها وابستگی زیادی دارند، حیاتی است.

    دومین جنبه، حفاظت از داده‌ها است. HA با استفاده از تکنیک‌های افزونگی، از داده‌ها در برابر خرابی‌های سخت‌افزاری محافظت می‌کند. در صورت خرابی یک دیسک یا کنترلر، سیستم به صورت خودکار به اجزای جایگزین سوئیچ می‌کند و از از دست رفتن داده جلوگیری می‌شود. این ویژگی یک لایه حفاظتی اضافی را فراهم می‌کند که مکمل استراتژی‌های پشتیبان‌گیری و بازیابی از فاجعه است. در واقع، HA به عنوان یک خط دفاعی اولیه در برابر خرابی‌های سخت‌افزاری عمل می‌کند.

    سومین جنبه، اعتماد مشتریان است. در دنیای رقابتی امروز، عدم دسترسی به سرویس‌ها می‌تواند به سرعت به از دست رفتن اعتماد مشتریان منجر شود. مشتریان انتظار دارند که خدمات به صورت پایدار و بدون وقفه ارائه شوند. HA با تضمین در دسترس بودن دائمی سرویس‌ها، به حفظ و افزایش وفاداری مشتریان کمک می‌کند و اعتبار سازمان را تقویت می‌کند. یک سیستم پایدار و قابل اعتماد، مزیت رقابتی بزرگی را برای سازمان به همراه می‌آورد.

    اجزای کلیدی یک معماری HA در ذخیره‌سازها

    یک معماری HA در ذخیره‌سازها بر چندین جزء اصلی استوار است که در کنار هم، یک سیستم پایدار را تشکیل می‌دهند. پیاده‌سازی این اجزا به صورت کامل، تضمین می‌کند که سیستم در برابر انواع مختلف خرابی‌ها مقاوم باشد.

    1. افزونگی سخت‌افزاری (Hardware Redundancy)

    استفاده از سخت‌افزارهای اضافی، اولین و مهم‌ترین قدم در پیاده‌سازی HA است. این شامل استفاده از آرایه‌های RAID (مانند RAID 1, RAID 5, RAID 6) در سطح دیسک است که در صورت خرابی یک یا چند دیسک، از از دست رفتن داده‌ها جلوگیری می‌کند. همچنین، در سیستم‌های ذخیره‌سازی باید از دو کنترلر و دو منبع تغذیه استفاده شود تا در صورت خرابی یکی از آن‌ها، دیگری به صورت خودکار وظایف را بر عهده بگیرد و سرویس‌دهی ادامه یابد. در نهایت، وجود پورت‌های شبکه اضافی و استفاده از کابل‌های چندگانه برای اتصال به سوییچ‌ها، از خرابی ناشی از قطع کابل‌ها جلوگیری می‌کند.

    2. خوشه‌بندی (Clustering)

    خوشه‌بندی به معنای ترکیب دو یا چند سیستم ذخیره‌سازی در یک واحد منطقی است. در این معماری، دو روش اصلی وجود دارد: خوشه‌بندی فعال-غیرفعال (Active-Passive) و خوشه‌بندی فعال-فعال (Active-Active). در حالت فعال-غیرفعال، یک گره (Node) به عنوان گره اصلی و فعال عمل می‌کند و گره دیگر در حالت غیرفعال و آماده به کار قرار دارد. در صورت خرابی گره اصلی، گره غیرفعال به صورت خودکار فعال شده و وظایف را بر عهده می‌گیرد. این روش ساده‌تر و ارزان‌تر است.

    در مقابل، در خوشه‌بندی فعال-فعال، هر دو گره به صورت همزمان فعال هستند و به درخواست‌های کاربران پاسخ می‌دهند. این روش بالاترین سطح در دسترس بودن و کارایی را فراهم می‌کند، زیرا بار کاری بین هر دو گره تقسیم می‌شود. در صورت خرابی یک گره، گره دیگر می‌تواند به تنهایی تمامی بار کاری را مدیریت کند. این روش برای برنامه‌های حیاتی که نیاز به عملکرد و پایداری بالا دارند، ایده‌آل است، اما پیچیدگی و هزینه بیشتری دارد.

    3. همگام‌سازی داده‌ها (Data Replication)

    همگام‌سازی داده‌ها به معنای کپی کردن داده‌ها از یک مکان اصلی به یک مکان جایگزین است. دو نوع اصلی همگام‌سازی وجود دارد: همگام‌سازی همزمان (Synchronous Replication) و همگام‌سازی ناهمزمان (Asynchronous Replication). در همگام‌سازی همزمان، داده‌ها به صورت همزمان روی هر دو سیستم نوشته می‌شوند، که این روش RPO (Recovery Point Objective) نزدیک به صفر را تضمین می‌کند، به این معنی که هیچ داده‌ای از دست نمی‌رود. این روش برای مسافت‌های کوتاه مناسب است، زیرا تأخیر بالا باعث کاهش عملکرد می‌شود.

    در همگام‌سازی ناهمزمان، داده‌ها ابتدا روی سیستم اصلی نوشته شده و سپس به صورت دوره‌ای به سیستم جایگزین منتقل می‌شوند. این روش RPO بالاتر از صفر را به همراه دارد، اما برای فواصل جغرافیایی دور مناسب است و تأخیر کمتری را در سیستم اصلی ایجاد می‌کند. انتخاب بین این دو روش به نیازهای سازمان برای RPO و مسافت بین دو دیتاسنتر بستگی دارد.

    پیاده‌سازی HA در محیط‌های ذخیره‌سازی

    پیاده‌سازی HA در محیط‌های NAS و SAN متفاوت است، زیرا هر یک از این سیستم‌ها دارای معماری و پروتکل‌های خاص خود هستند.

    1. HA در محیط‌های NAS

    NAS به عنوان یک راهکار ذخیره‌سازی سطح فایل، HA را از طریق خوشه‌بندی فعال-غیرفعال یا فعال-فعال پیاده‌سازی می‌کند. در این حالت، دو دستگاه NAS به صورت خوشه‌بندی شده عمل می‌کنند. در صورت خرابی یک دستگاه، دستگاه دیگر به صورت خودکار کنترل را به دست می‌گیرد و سرویس‌دهی ادامه می‌یابد. این فرآیند معمولاً از طریق یک آدرس IP مجازی که بین دو دستگاه جابجا می‌شود، مدیریت می‌گردد. پیاده‌سازی HA در NAS نسبت به SAN ساده‌تر و کم‌هزینه‌تر است، که آن را برای کسب‌وکارهای کوچک و متوسط جذاب می‌کند.

    2. HA در محیط‌های SAN

    SAN به عنوان یک راهکار ذخیره‌سازی سطح بلوک، HA را از طریق افزونگی در تمامی اجزا (کنترلرها، سوییچ‌ها، پورت‌ها و کابل‌ها) و همچنین همگام‌سازی داده‌ها پیاده‌سازی می‌کند. در SAN، معمولاً از خوشه‌بندی فعال-فعال برای تضمین بالاترین سطح در دسترس بودن استفاده می‌شود. در این معماری، هر دو کنترلر در آرایه‌های ذخیره‌سازی به صورت همزمان فعال هستند و می‌توانند به درخواست‌های ورودی/خروجی پاسخ دهند. این امر عملکرد را به شدت افزایش می‌دهد و از ایجاد گلوگاه‌ها جلوگیری می‌کند.

    مقایسه HA در NAS و SAN

    ویژگی HA در NAS HA در SAN
    نوع داده فایل‌ها و پوشه‌ها داده‌های سطح بلوک، پایگاه داده‌ها
    روش پیاده‌سازی خوشه‌بندی دستگاه‌ها افزونگی اجزا، خوشه‌بندی، همگام‌سازی
    عملکرد وابسته به شبکه LAN بسیار بالا، وابسته به شبکه اختصاصی
    RPO و RTO معمولاً بالاتر نزدیک به صفر یا بسیار پایین
    هزینه و پیچیدگی نسبتاً پایین بالا تا بسیار بالا


    چالش‌های پیاده‌سازی High Availability

    با وجود مزایای فراوان، پیاده‌سازی HA با چالش‌هایی نیز همراه است که باید به آن‌ها توجه کرد.

    1. هزینه بالا

    پیاده‌سازی HA نیازمند سرمایه‌گذاری سنگین در سخت‌افزار، نرم‌افزار و زیرساخت شبکه است. خرید سخت‌افزارهای اضافی، مانند کنترلرها، منابع تغذیه، و سوییچ‌های گران‌قیمت می‌تواند هزینه را به شدت افزایش دهد. علاوه بر این، نرم‌افزارهای مدیریت HA و لایسنس‌های آن‌ها نیز قیمت بالایی دارند. این هزینه‌ها باید در مقابل مزایای بلندمدت HA، مانند کاهش خسارات ناشی از از کارافتادگی، سنجیده شوند.

    2. پیچیدگی فنی

    طراحی، نصب و نگهداری یک معماری HA، پیچیده است و نیاز به تخصص فنی دارد. مدیریت خوشه‌ها، همگام‌سازی داده‌ها و عیب‌یابی مشکلات، نیازمند دانش عمیق در زمینه سیستم‌های ذخیره‌سازی، شبکه و پروتکل‌های مربوطه است. هرگونه پیکربندی نادرست می‌تواند منجر به مشکلات بزرگ‌تری شود و کل سیستم را به خطر بیندازد. به همین دلیل، پیاده‌سازی HA باید توسط متخصصان مجرب انجام شود.

    3. مدیریت پیچیدگی

    با افزایش تعداد اجزای سیستم، مدیریت و نظارت بر تمامی آن‌ها نیز پیچیده‌تر می‌شود. نرم‌افزارهای مدیریتی پیشرفته برای ساده‌سازی این فرآیند ضروری هستند. این نرم‌افزارها به مدیران اجازه می‌دهند تا وضعیت تمامی اجزا را از یک کنسول واحد بررسی کنند، هشدارهای لازم را دریافت کرده و به صورت خودکار به مشکلات واکنش نشان دهند. بدون این ابزارها، مدیریت یک سیستم HA در مقیاس بزرگ، عملاً غیرممکن است.

    نقش مجازی‌سازی در High Availability

    مجازی‌سازی به یکی از مهم‌ترین فناوری‌ها برای پیاده‌سازی HA تبدیل شده است. با استفاده از پلتفرم‌های مجازی‌سازی مانند VMware و Hyper-V، می‌توان HA را در سطح سرور و برنامه نیز پیاده‌سازی کرد.

    در یک محیط مجازی‌سازی، می‌توان ماشین‌های مجازی را بر روی چندین سرور فیزیکی اجرا کرد. اگر یکی از سرورها خراب شود، ماشین‌های مجازی می‌توانند به صورت خودکار به سرور دیگری منتقل شوند و به کار خود ادامه دهند. این قابلیت که با نام Live Migration یا HA در پلتفرم‌های مجازی‌سازی شناخته می‌شود، به کاهش زمان از کارافتادگی در سطح سرور کمک می‌کند. علاوه بر این، مجازی‌سازی امکان اجرای چندین نسخه از یک برنامه را بر روی سرورهای مختلف فراهم می‌کند که در صورت خرابی یکی از آن‌ها، دیگری به صورت خودکار فعال شده و سرویس‌دهی را ادامه می‌دهد.

    تفاوت HA و Disaster Recovery) DR)

    مفاهیم HA و DR اغلب با یکدیگر اشتباه گرفته می‌شوند، اما تفاوت‌های کلیدی دارند. HA بر جلوگیری از توقف عملیات در وهله اول تمرکز دارد. هدف HA، به حداقل رساندن زمان از کارافتادگی ناشی از خرابی‌های سخت‌افزاری یا نرم‌افزاری در یک مکان فیزیکی است. به همین دلیل، HA از افزونگی و خوشه‌بندی در یک دیتاسنتر واحد استفاده می‌کند.

    در مقابل، Disaster Recovery (DR) بر بازیابی سیستم‌ها و داده‌ها پس از یک فاجعه بزرگ که ممکن است کل یک دیتاسنتر یا منطقه جغرافیایی را تحت تأثیر قرار دهد، تمرکز دارد. DR از طریق پشتیبان‌گیری و همگام‌سازی داده‌ها در یک مکان فیزیکی جداگانه (آف‌سایت) عمل می‌کند. در واقع، HA و DR مکمل یکدیگر هستند. HA از وقوع خرابی‌های کوچک جلوگیری می‌کند و DR تضمین می‌کند که در صورت وقوع یک فاجعه بزرگ، سیستم‌ها و داده‌ها قابل بازیابی باشند.

    سنجش کارایی و اثربخشی HA

    برای اطمینان از اینکه معماری HA به درستی کار می‌کند، باید به صورت منظم کارایی و اثربخشی آن را سنجید. این سنجش از طریق شاخص‌های کلیدی و آزمایش‌های دوره‌ای صورت می‌گیرد.

    اولین شاخص، درصد زمان کارکرد (Uptime Percentage) است. این شاخص نشان می‌دهد که سیستم در یک بازه زمانی مشخص، چند درصد از وقت را فعال بوده است. برای مثال، ۵ دقیقه از کارافتادگی در یک سال، معادل ۹۹.۹۹۹٪ زمان کارکرد است. دومین شاخص، مدت زمان متوسط بین خرابی‌ها (MTBF) است که میانگین زمانی را که سیستم می‌تواند بدون خرابی کار کند، نشان می‌دهد. هر چه این عدد بزرگ‌تر باشد، سیستم قابل اعتمادتر است.

    علاوه بر این، باید به صورت منظم تمرین‌های شبیه‌سازی برای تست سناریوهای مختلف خرابی برگزار کرد. این تمرین‌ها به تیم‌های IT کمک می‌کنند تا با فرآیندهای سوئیچ به گره جایگزین آشنا شوند و نقاط ضعف سیستم را شناسایی کنند. این آزمایش‌ها باید شامل خرابی دیسک، کنترلر، سوییچ و حتی قطع برق باشد تا از آمادگی کامل سیستم در برابر تمامی تهدیدات اطمینان حاصل شود.

    آینده High Availability در ذخیره‌سازها

    آینده HA به سمت استفاده از فناوری‌های نوین مانند رایانش ابری (Cloud Computing)، هوش مصنوعی (AI) و یادگیری ماشین (Machine Learning) در حال حرکت است. ارائه‌دهندگان ابری، راه‌حل‌های HA پیشرفته‌ای را ارائه می‌دهند که به صورت خودکار داده‌ها را در دیتاسنترهای مختلف کپی می‌کنند و در دسترس بودن بالا را تضمین می‌کنند.

    هوش مصنوعی و یادگیری ماشین نیز نقش مهمی در پیش‌بینی خرابی‌ها قبل از وقوع آن‌ها ایفا می‌کنند. با تحلیل داده‌های عملکردی سیستم‌ها، این فناوری‌ها می‌توانند الگوهای خرابی را شناسایی کرده و به مدیران هشدار دهند تا قبل از وقوع فاجعه، اقدامات لازم را انجام دهند. این رویکرد پیشگیرانه، به کاهش زمان از کارافتادگی و افزایش پایداری سیستم‌ها کمک شایانی می‌کند. در نهایت، آینده HA به سمت سیستم‌هایی است که خودکار، هوشمند و قادر به پیش‌بینی و پیشگیری از خرابی‌ها هستند.

    نتیجه‌گیری

    High Availability یک مفهوم حیاتی در زیرساخت‌های ذخیره‌سازی مدرن است که فراتر از یک گزینه انتخابی، به یک ضرورت تجاری تبدیل شده است. با پیاده‌سازی یک معماری HA، سازمان‌ها می‌توانند از داده‌های ارزشمند خود در برابر خرابی‌ها و بلایا محافظت کرده و از تداوم عملیات کسب‌وکار خود اطمینان حاصل کنند. از افزونگی سخت‌افزاری و خوشه‌بندی گرفته تا همگام‌سازی داده‌ها، هر یک از این اجزا نقش حیاتی در ایجاد یک زیرساخت ذخیره‌سازی پایدار و قابل اعتماد دارند. در نهایت، با درک دقیق نیازهای خود و برنامه‌ریزی استراتژیک، می‌توانید یک راه‌حل HA را پیاده‌سازی کنید که آینده کسب‌وکار شما را تضمین خواهد کرد.

    سوالات متداول 

    1. چه تفاوتی بین High Availability و Disaster Recovery وجود دارد؟
      High Availability (HA) بر جلوگیری از توقف عملیات در وهله اول تمرکز دارد. هدف آن به حداقل رساندن زمان از کارافتادگی ناشی از خرابی‌های سخت‌افزاری یا نرم‌افزاری در یک مکان فیزیکی است. در مقابل، Disaster Recovery (DR) بر بازیابی سیستم‌ها و داده‌ها پس از یک فاجعه بزرگ مانند بلایای طبیعی یا حملات باج‌افزار تمرکز دارد که کل یک سایت یا دیتاسنتر را تحت تأثیر قرار می‌دهد. HA و DR مکمل یکدیگر هستند و هر دو برای تداوم کسب‌وکار ضروری هستند.
    2. آیا RAID به تنهایی برای High Availability کافی است؟
      خیر، RAID به تنهایی برای HA کافی نیست. RAID برای محافظت از داده‌ها در برابر خرابی یک یا چند دیسک در یک آرایه طراحی شده است. اما نمی‌تواند از سیستم در برابر خرابی کنترلر، منبع تغذیه، یا کل سرور محافظت کند. برای پیاده‌سازی HA واقعی، نیاز به افزونگی در تمامی اجزای سیستم، از جمله کنترلرها، منابع تغذیه و شبکه‌ها دارید.
    3. بهترین راهکار برای پیاده‌سازی HA در یک کسب‌وکار کوچک چیست؟
      برای یک کسب‌وکار کوچک، بهترین راهکار معمولاً استفاده از سیستم‌های NAS با قابلیت خوشه‌بندی فعال-غیرفعال است. این سیستم‌ها هزینه کمتری نسبت به راه‌حل‌های SAN دارند و مدیریت آن‌ها ساده‌تر است. با پیاده‌سازی یک سیستم NAS با افزونگی، می‌توانید از در دسترس بودن فایل‌ها و داده‌های خود اطمینان حاصل کنید، بدون اینکه نیاز به سرمایه‌گذاری سنگین در زیرساخت‌های پیچیده SAN داشته باشید.
    4. چگونه می‌توان از کارایی یک معماری HA اطمینان حاصل کرد؟
      برای اطمینان از کارایی یک معماری HA، باید به صورت منظم آن را آزمایش کنید. تمرین‌های شبیه‌سازی خرابی، مانند قطع برق یک کنترلر یا خراب کردن یک دیسک، به شما کمک می‌کند تا آمادگی سیستم را بسنجید. همچنین، باید شاخص‌هایی مانند RTO) Recovery Time Objective) و (RPO) Recovery Point Objective را اندازه‌گیری کرده و مطمئن شوید که سیستم می‌تواند به اهداف تعیین‌شده دست یابد.
    5. آیا High Availability در رایانش ابری به صورت خودکار فراهم می‌شود؟
      بسیاری از ارائه‌دهندگان رایانش ابری، راه‌حل‌های HA را به صورت خودکار فراهم می‌کنند. برای مثال، آن‌ها داده‌ها را در چندین دیتاسنتر مختلف کپی می‌کنند تا از در دسترس بودن دائمی آن‌ها اطمینان حاصل کنند. با این حال، مسئولیت پیاده‌سازی و پیکربندی صحیح سرویس‌های ابری برای دستیابی به HA همچنان بر عهده سازمان است. برای مثال، باید از سرویس‌های پایدار و افزونه استفاده کرد و مطمئن شد که داده‌ها در مناطق جغرافیایی مختلف به درستی همگام‌سازی شده‌اند.


  • معرفی معماری HCI و مقایسه با SAN/NAS

    معرفی معماری HCI و مقایسه با SAN/NAS

    در دنیای مدرن فناوری اطلاعات، زیرساخت‌های سنتی دیتاسنتر با چالش‌های بزرگی روبرو هستند. پیچیدگی مدیریت، هزینه‌های بالا و مقیاس‌پذیری دشوار، سازمان‌ها را به سمت جستجوی راه‌حل‌های نوین سوق داده است. در این میان، معماری Hyperconverged Infrastructure (HCI) به عنوان یک رویکرد انقلابی، تمامی اجزای اصلی دیتاسنتر را در یک سیستم واحد و یکپارچه ترکیب کرده است. این معماری، مدیریت زیرساخت را به شکل چشمگیری ساده می‌کند و به سازمان‌ها اجازه می‌دهد تا با چابکی بیشتری به نیازهای بازار پاسخ دهند.

    این محتوای جامع، به شما کمک می‌کند تا به صورت کامل با مفهوم HCI، اجزای کلیدی آن، مزایا و معایب و همچنین تفاوت‌های اساسی آن با معماری‌های سنتی SAN و NAS آشنا شوید.

    HCI چیست؟ ترکیب هوشمندانه پردازش، ذخیره‌سازی و شبکه

    Hyperconverged Infrastructure) HCI) یک چارچوب فناوری اطلاعات است که تمامی اجزای اصلی دیتاسنتر شامل پردازش (Compute)، ذخیره‌سازی (Storage) و شبکه (Networking) را در یک پلتفرم واحد و مقیاس‌پذیر ترکیب می‌کند. برخلاف زیرساخت‌های سنتی که این اجزا به صورت جداگانه و در لایه‌های مختلف مدیریت می‌شوند، در HCI تمامی این وظایف توسط یک نرم‌افزار واحد بر روی سخت‌افزارهای استاندارد (Commodity Hardware) انجام می‌شود. این یکپارچگی، پیچیدگی را به شدت کاهش می‌دهد و مدیریت را ساده‌تر می‌کند.

    یک پلتفرم HCI از سه جزء اصلی تشکیل شده است که به صورت نرم‌افزاری با یکدیگر کار می‌کنند. لایه پردازش شامل ماشین‌های مجازی (VMs) است که بر روی یک Hypervisor (مانند VMware ESXi، Microsoft Hyper-V یا KVM) اجرا می‌شوند. هر سرور در یک کلاستر HCI، هم وظیفه پردازش و هم ذخیره‌سازی را بر عهده دارد. این هم‌گرایی، نیاز به سخت‌افزارهای جداگانه را از بین می‌برد و زیرساخت را بسیار انعطاف‌پذیر می‌کند.

    لایه ذخیره‌سازی توزیع‌شده، تمامی فضای ذخیره‌سازی محلی (DAS) سرورها را در یک مخزن ذخیره‌سازی واحد و توزیع‌شده ترکیب می‌کند. این نرم‌افزار، قابلیت‌هایی مانند افزونگی (Redundancy)، فشرده‌سازی و حذف داده‌های تکراری (Deduplication) را فراهم می‌کند تا کارایی و بهینگی فضای ذخیره‌سازی را به حداکثر برساند. در نهایت، تمامی ارتباطات شبکه داخلی بین سرورها و ماشین‌های مجازی از طریق یک لایه نرم‌افزاری مدیریت می‌شود که مدیریت شبکه را ساده و یکپارچه می‌کند.

    تفاوت HCI با زیرساخت‌های سنتی SAN و NAS

    برای درک بهتر HCI، باید آن را با معماری‌های سنتی SAN و NAS مقایسه کرد. زیرساخت‌های سنتی به صورت لایه‌ای طراحی شده‌اند که در آن‌ها، سرورها، شبکه و ذخیره‌سازی به صورت جداگانه مدیریت می‌شوند. این جدایی، پیچیدگی و چالش‌های خاص خود را به همراه دارد.

    در یک دیتاسنتر سنتی، سرورها به صورت جداگانه، تجهیزات شبکه (مانند سوییچ‌ها) به صورت جداگانه و سیستم‌های ذخیره‌سازی (SAN یا NAS) نیز به صورت جداگانه مدیریت و مقیاس‌پذیر می‌شوند. برای مثال، SAN یک شبکه اختصاصی و پرسرعت برای ذخیره‌سازی سطح بلوک است که از سوییچ‌های گران‌قیمت و آرایه‌های ذخیره‌سازی مجزا تشکیل شده است. در حالی که NAS یک دستگاه اختصاصی برای ذخیره‌سازی سطح فایل است که به صورت مستقیم به شبکه محلی متصل می‌شود.

    در معماری HCI، تمامی این اجزا در یک سیستم واحد ترکیب می‌شوند. این یکپارچگی، مزایای بزرگی را به همراه دارد. مدیریت به جای مدیریت سه لایه جداگانه، تنها یک سیستم واحد را مدیریت می‌کنند. مقیاس‌پذیری نیز به سادگی و به صورت خطی انجام می‌شود، زیرا با اضافه کردن یک گره (سرور) جدید، ظرفیت پردازش، ذخیره‌سازی و شبکه به صورت همزمان افزایش می‌یابد. علاوه بر این، HCI از سخت‌افزارهای استاندارد استفاده می‌کند و نیاز به تجهیزات گران‌قیمت مانند سوییچ‌های Fibre Channel را از بین می‌برد که به کاهش هزینه کمک می‌کند.

    مزایای کلیدی Hyperconverged Infrastructure) HCI)

    HCI به دلیل مزایای بی‌شماری که ارائه می‌دهد، به سرعت در حال محبوب شدن است. این مزایا به سازمان‌ها اجازه می‌دهند تا به صورت کارآمدتر و چابک‌تر عمل کنند و به سرعت به نیازهای بازار پاسخ دهند.

    1. کاهش پیچیدگی و مدیریت آسان

    یکی از بزرگ‌ترین مزایای HCI، کاهش چشمگیر پیچیدگی است. این معماری تمامی اجزا را در یک پلتفرم واحد ترکیب می‌کند و مدیران IT تمامی منابع را از یک کنسول واحد مدیریت می‌کنند. این یکپارچگی، نیاز به چندین ابزار مدیریتی و تیم‌های متخصص را از بین می‌برد و فرآیندهای مدیریتی را به شدت ساده می‌کند.

    بسیاری از فرآیندهای مدیریتی در HCI، مانند تأمین منابع و به‌روزرسانی‌ها، به صورت خودکار انجام می‌شوند. این خودکارسازی، خطاهای انسانی را کاهش می‌دهد و به مدیران اجازه می‌دهد تا به جای انجام کارهای تکراری، بر روی وظایف استراتژیک‌تر تمرکز کنند. این امر به افزایش بهره‌وری کلی تیم IT منجر می‌شود.

    2. مقیاس‌پذیری خطی و آسان

    HCI برای مقیاس‌پذیری طراحی شده است و برخلاف زیرساخت‌های سنتی، این فرآیند را بسیار ساده می‌کند. با اضافه کردن یک سرور (گره) جدید، ظرفیت پردازش، ذخیره‌سازی و شبکه به صورت همزمان و خطی افزایش می‌یابد. این قابلیت به سازمان‌ها امکان می‌دهد تا با توجه به نیازهای خود، به صورت مرحله‌ای سرمایه‌گذاری کنند و از هزینه‌های اضافی جلوگیری کنند.

    این مقیاس‌پذیری ماژولار، به سازمان‌ها امکان می‌دهد تا با سرعت به نیازهای رو به رشد پاسخ دهند. برای مثال، اگر یک برنامه کاربردی جدید به منابع بیشتری نیاز داشته باشد، می‌توان به سادگی یک گره جدید به کلاستر اضافه کرد. این انعطاف‌پذیری، HCI را برای محیط‌های پویا مانند رایانش ابری و دسکتاپ‌های مجازی ایده‌آل می‌کند.

    3. هزینه کل مالکیت (TCO) پایین‌تر

    HCI در بلندمدت می‌تواند هزینه کل مالکیت (TCO) را به شکل چشمگیری کاهش دهد. این معماری از سخت‌افزارهای استاندارد و ارزان‌تر استفاده می‌کند که نیاز به تجهیزات گران‌قیمت اختصاصی مانند سوییچ‌های Fibre Channel و آرایه‌های ذخیره‌سازی مجزا را از بین می‌برد. این امر به کاهش هزینه‌های سخت‌افزاری کمک می‌کند.

    علاوه بر این، سادگی مدیریت HCI، به کاهش هزینه‌های مربوط به نیروی انسانی و نگهداری کمک می‌کند. تیم‌های IT به جای صرف وقت برای مدیریت چندین سیستم جداگانه، می‌توانند بر روی یک پلتفرم واحد تمرکز کنند. همچنین، HCI فضای کمتری را در دیتاسنتر اشغال می‌کند و مصرف انرژی و هزینه‌های خنک‌سازی آن نیز پایین‌تر است که به کاهش هزینه‌های عملیاتی در بلندمدت منجر می‌شود.

    چالش‌ها و معایب Hyperconverged Infrastructure

    با وجود مزایای فراوان، HCI نیز بدون چالش نیست. شناخت این معایب برای تصمیم‌گیری آگاهانه ضروری است.

    1. هزینه اولیه بالا

    اگرچه TCO در بلندمدت پایین است، اما هزینه اولیه برای خرید یک پلتفرم HCI می‌تواند بالا باشد. این هزینه شامل خرید گره‌های سخت‌افزاری، لایسنس نرم‌افزاری و هزینه‌های پیاده‌سازی است. این امر ممکن است برای سازمان‌های کوچک با بودجه محدود، یک مانع باشد. با این حال، باید این هزینه را در مقابل هزینه‌های بلندمدت و پیچیدگی زیرساخت‌های سنتی سنجید.

    2. وابستگی به یک فروشنده

    HCI یک راه‌حل یکپارچه است و ممکن است سازمان را به یک فروشنده خاص وابسته کند. جابجایی از یک پلتفرم HCI به پلتفرم دیگر ممکن است دشوار و زمان‌بر باشد، زیرا نرم‌افزار و سخت‌افزار به صورت یکپارچه کار می‌کنند. این وابستگی به فروشنده می‌تواند قدرت چانه‌زنی سازمان را در آینده کاهش دهد.

    3. مناسب برای تمامی کاربردها نیست

    HCI برای برخی از کاربردهای خاص، مانند پایگاه‌های داده‌های بسیار بزرگ یا محیط‌هایی که نیاز به دسترسی مستقیم به داده‌های خام دارند، مناسب نیست. در این موارد، زیرساخت‌های سنتی SAN ممکن است عملکرد بهتری را ارائه دهند. بنابراین، سازمان باید نیازهای عملکردی و نوع کاربردهای خود را به دقت بررسی کند و سپس تصمیم به پیاده‌سازی HCI بگیرد.

    مقایسه HCI و زیرساخت‌های سنتی (SAN/NAS)

    ویژگی

    زیرساخت سنتی (SAN/NAS)

    Hyperconverged Infrastructure (HCI)

    معماری

    لایه‌ای و جداگانه

    یکپارچه و نرم‌افزارمحور

    اجزا

    سرورها، شبکه و ذخیره‌سازی مجزا

    پردازش، ذخیره‌سازی و شبکه در یک سیستم

    مقیاس‌پذیری

    پیچیده و زمان‌بر

    ساده و خطی

    مدیریت

    نیازمند چندین ابزار و تیم متخصص

    متمرکز و با یک کنسول واحد

    هزینه اولیه

    معمولاً پایین‌تر (در مقیاس کوچک)

    معمولاً بالاتر

    هزینه کل مالکیت (TCO)

    معمولاً بالاتر

    پایین‌تر

    مناسب برای

    پایگاه‌های داده‌های بزرگ، محیط‌های پیچیده

    مجازی‌سازی، VDI، دسکتاپ‌های مجازی


    نقش HCI در دیتاسنترهای مدرن

    HCI به دلیل انعطاف‌پذیری و سادگی، به یک فناوری کلیدی در دیتاسنترهای مدرن تبدیل شده است. این معماری برای پاسخگویی به نیازهای در حال رشد سازمان‌ها در محیط‌های مختلف بسیار کارآمد است.

    1. مجازی‌سازی و VDI (Virtual Desktop Infrastructure)

    HCI بهترین راهکار برای پیاده‌سازی زیرساخت‌های مجازی‌سازی و VDI است. با توجه به اینکه VDI به حجم بالایی از منابع پردازشی و ذخیره‌سازی نیاز دارد، HCI با ترکیب این منابع در یک سیستم واحد، عملکرد و مقیاس‌پذیری لازم را فراهم می‌کند. این معماری به مدیران اجازه می‌دهد تا به راحتی دسکتاپ‌های مجازی را ایجاد، مدیریت و به کاربران ارائه دهند.

    2. رایانش ابری هیبریدی (Hybrid Cloud)

    HCI به عنوان یک بستر برای ساخت یک ابر خصوصی (Private Cloud) عمل می‌کند که می‌تواند به راحتی با ابرهای عمومی (Public Clouds) یکپارچه شود. این امر به سازمان‌ها امکان می‌دهد تا یک استراتژی رایانش ابری هیبریدی را پیاده‌سازی کنند و داده‌های خود را به صورت هوشمند بین محیط محلی و ابر عمومی جابجا کنند.

    3. دفاتر از راه دور و شعب (Remote Office/Branch Office – ROBO)

    HCI به دلیل سادگی در نصب و مدیریت، یک گزینه ایده‌آل برای دفاتر از راه دور و شعب است که دارای تیم‌های IT کوچک یا بدون تیم هستند. این سیستم‌ها می‌توانند به صورت متمرکز از دیتاسنتر اصلی مدیریت شوند، که این امر هزینه‌های مدیریتی را به شدت کاهش می‌دهد و به سازمان امکان می‌دهد تا به راحتی زیرساخت‌های خود را در شعب مختلف گسترش دهد.

    مهاجرت از زیرساخت‌های سنتی به HCI

    مهاجرت از زیرساخت‌های سنتی به HCI یک فرآیند استراتژیک است که نیازمند برنامه‌ریزی دقیق است. این فرآیند باید به صورت مرحله‌ای و با در نظر گرفتن نیازهای سازمان انجام شود تا از هرگونه اختلال در عملیات جلوگیری گردد.

    در مرحله اول، سازمان باید یک ارزیابی جامع از زیرساخت موجود خود انجام دهد و برنامه‌های کاربردی حیاتی را شناسایی کند. این ارزیابی به سازمان کمک می‌کند تا مشخص کند کدام برنامه‌ها می‌توانند به HCI منتقل شوند و کدامیک باید در زیرساخت سنتی باقی بمانند. پس از آن، سازمان می‌تواند یک کلاستر HCI کوچک را برای تست و ارزیابی عملکرد پیاده‌سازی کند.

    در مرحله بعد، سازمان می‌تواند به صورت مرحله‌ای برنامه‌های غیرحیاتی را به HCI منتقل کند. این فرآیند می‌تواند در طول زمان و به تدریج انجام شود تا ریسک‌ها به حداقل برسند. در نهایت، با کسب تجربه و اطمینان از عملکرد HCI، سازمان می‌تواند برنامه‌های حیاتی خود را نیز به این پلتفرم منتقل کند. این رویکرد تدریجی، ریسک‌های مهاجرت را کاهش می‌دهد و به سازمان اجازه می‌دهد تا به صورت هوشمندانه از زیرساخت‌های موجود خود بهره ببرد.

    نقش HCI در افزایش چابکی کسب‌وکار

    در دنیای کسب‌وکار امروز، چابکی و توانایی پاسخ سریع به تغییرات بازار، یک مزیت رقابتی حیاتی است. HCI با ساده‌سازی مدیریت زیرساخت و افزایش مقیاس‌پذیری، به سازمان‌ها کمک می‌کند تا به این چابکی دست یابند. این معماری به مدیران IT اجازه می‌دهد تا به سرعت منابع پردازشی و ذخیره‌سازی را برای توسعه پروژه‌های جدید، راه‌اندازی برنامه‌های کاربردی جدید یا پاسخ به نیازهای موقتی، فراهم کنند.

    این فرآیند که در زیرساخت‌های سنتی زمان‌بر و پیچیده است، در HCI در عرض چند دقیقه انجام می‌شود. این سرعت در تأمین منابع، به تیم‌های توسعه نرم‌افزار اجازه می‌دهد تا با سرعت بیشتری کار کنند و محصولات جدید را به بازار عرضه کنند. در نهایت، سادگی مدیریت HCI، به مدیران اجازه می‌دهد تا به جای صرف وقت برای مدیریت سخت‌افزار، بر روی نوآوری و بهبود خدمات تمرکز کنند. این تغییر در اولویت‌ها، به سازمان‌ها کمک می‌کند تا در بازار رقابتی امروز، پیشتاز باشند و به صورت مؤثرتر به نیازهای مشتریان خود پاسخ دهند.

    آینده HCI: از هم‌گرایی تا یکپارچگی کامل

    آینده HCI به سمت یکپارچگی کامل‌تر و ارائه یک پلتفرم جامع برای تمامی نیازهای دیتاسنتر در حال حرکت است. انتظار می‌رود HCI در آینده، نه تنها پردازش، ذخیره‌سازی و شبکه را ترکیب کند، بلکه قابلیت‌های امنیتی، بکاپ و بازیابی از فاجعه را نیز به صورت بومی و یکپارچه ارائه دهد. این تکامل، پیچیدگی مدیریت را به شکل بی‌سابقه‌ای کاهش خواهد داد و به سازمان‌ها امکان می‌دهد تا زیرساخت خود را از یک کنسول واحد مدیریت کنند.

    HCI همچنین نقش مهمی در معماری‌های لبه (Edge Computing) ایفا خواهد کرد. با توجه به سادگی و کارایی، HCI یک گزینه ایده‌آل برای استقرار در مکان‌های از راه دور است که تیم‌های IT محدودی دارند. این معماری به سازمان‌ها اجازه می‌دهد تا داده‌ها را در نزدیکی محل تولید آن‌ها پردازش و ذخیره کنند و از تأخیر در شبکه جلوگیری کنند. در نهایت، HCI در آینده به یک پلتفرم اصلی برای ساخت ابرهای خصوصی و هیبریدی تبدیل خواهد شد.

    انتخاب فروشنده و اکوسیستم HCI

    انتخاب یک فروشنده مناسب، یکی از مهم‌ترین تصمیمات در پیاده‌سازی HCI است. در بازار HCI، فروشندگان متعددی از جمله VMware (با VMware Cloud Foundation)، Dell Technologies (با VxRail)، Nutanix و HPE (با SimpliVity) حضور دارند. هر فروشنده دارای نقاط قوت و ضعف خاص خود است و انتخاب باید بر اساس نیازهای سازمان، پشتیبانی، و اکوسیستم موجود انجام شود.

    سازمان باید به عواملی مانند سازگاری با زیرساخت فعلی (مثلاً اگر سازمان از VMware استفاده می‌کند، راه‌حل VMware Cloud Foundation مناسب‌تر است)، قابلیت‌های نرم‌افزاری ارائه شده، خدمات پشتیبانی پس از فروش و هزینه کلی توجه کند. علاوه بر این، باید به اکوسیستم فروشنده نیز توجه کرد. یک اکوسیستم قوی شامل ابزارهای مدیریتی، قابلیت‌های امنیتی و راهکارهای پشتیبان‌گیری است که به سازمان کمک می‌کند تا به صورت یکپارچه با سیستم کار کند.

    بررسی شاخص‌های عملکردی HCI

    HCI با وعده ارائه عملکرد بالا و مقیاس‌پذیری خطی وارد بازار شده است. برای ارزیابی صحت این ادعا، سازمان باید شاخص‌های عملکردی کلیدی را بررسی کند. این شاخص‌ها شامل IOPS (Input/Output Operations Per Second) و توان عملیاتی (Throughput) است. این شاخص‌ها نشان می‌دهند که سیستم در یک بازه زمانی مشخص، چند عملیات ورودی و خروجی را می‌تواند انجام دهد.

    علاوه بر این، باید به تأخیر (Latency) نیز توجه کرد. HCI ممکن است در برخی موارد تأخیر بالاتری نسبت به SAN داشته باشد، چرا که لایه ذخیره‌سازی آن نرم‌افزاری است و از طریق شبکه داخلی کار می‌کند. بنابراین، برای برنامه‌های حیاتی که به تأخیر بسیار پایین نیاز دارند، باید این شاخص‌ها به دقت بررسی شوند.

    نتیجه‌گیری

    معماری HCI یک تغییر پارادایم در طراحی دیتاسنتر است. با ترکیب هوشمندانه پردازش، ذخیره‌سازی و شبکه در یک پلتفرم واحد، HCI پیچیدگی را کاهش می‌دهد، مقیاس‌پذیری را ساده می‌کند و هزینه‌های کل مالکیت را کاهش می‌دهد. در حالی که زیرساخت‌های سنتی SAN و NAS همچنان برای برخی از کاربردهای خاص مناسب هستند، HCI به عنوان یک راه‌حل کارآمد و انعطاف‌پذیر برای محیط‌های مدرن مانند مجازی‌سازی، VDI و رایانش ابری هیبریدی، به سرعت در حال تبدیل شدن به یک استاندارد صنعتی است. با درک دقیق این تفاوت‌ها، سازمان‌ها می‌توانند یک تصمیم استراتژیک برای آینده زیرساخت فناوری اطلاعات خود اتخاذ کنند.

    سوالات متداول 

    1. آیا HCI می‌تواند جایگزین کامل SAN شود؟
      HCI یک جایگزین قدرتمند و کارآمد برای SAN در بسیاری از محیط‌ها، به ویژه در مجازی‌سازی، VDI و دفاتر از راه دور است. با این حال، HCI ممکن است برای تمامی کاربردها، به ویژه پایگاه‌های داده‌های بسیار بزرگ که نیاز به تأخیر بسیار پایین و عملکرد فوق‌العاده دارند، مناسب نباشد. در این موارد، زیرساخت‌های سنتی SAN همچنان عملکرد بهتری را ارائه می‌دهند.

    2. آیا HCI برای کسب‌وکارهای کوچک نیز مناسب است؟
      بله، HCI برای کسب‌وکارهای کوچک و متوسط نیز مناسب است. سادگی مدیریت و مقیاس‌پذیری ماژولار آن، به تیم‌های IT کوچک اجازه می‌دهد تا زیرساخت خود را به راحتی مدیریت کنند، بدون اینکه نیاز به تخصص عمیق در زمینه SAN و شبکه داشته باشند. همچنین، با توجه به اینکه می‌توانید از یک کلاستر کوچک شروع کرده و به تدریج آن را گسترش دهید، این مدل از نظر هزینه نیز برای کسب‌وکارهای کوچک قابل توجیه است.

    3. HCI چگونه بر امنیت داده‌ها تأثیر می‌گذارد؟
      HCI می‌تواند امنیت داده‌ها را بهبود بخشد، زیرا تمامی اجزا در یک سیستم واحد و متمرکز مدیریت می‌شوند. این امر به مدیران اجازه می‌دهد تا سیاست‌های امنیتی، از جمله رمزنگاری داده‌ها و مدیریت دسترسی، را از یک کنسول واحد اعمال کنند. با این حال، امنیت نهایی به پیاده‌سازی صحیح و مدیریت مداوم بستگی دارد. برخی از پلتفرم‌های HCI قابلیت‌هایی مانند رمزنگاری بومی داده‌ها و حفاظت از داده‌ها در برابر باج‌افزار را ارائه می‌دهند.

    4. HCI و Cloud Computing چه ارتباطی با هم دارند؟
      HCI به سازمان‌ها اجازه می‌دهد تا یک زیرساخت ابری خصوصی (Private Cloud) را در محل خود (On-Premises) ایجاد کنند. این زیرساخت می‌تواند به راحتی با ابرهای عمومی (Public Clouds) یکپارچه شود و یک راهکار ابری هیبریدی (Hybrid Cloud) را ایجاد کند. این ارتباط به سازمان‌ها امکان می‌دهد تا از مزایای هر دو مدل، یعنی کنترل داده‌های محلی و انعطاف‌پذیری ابر عمومی، بهره ببرند.


  • معرفی ZFS File System و کاربرد آن در NAS/SAN

    معرفی ZFS File System و کاربرد آن در NAS/SAN

    در دنیای فناوری اطلاعات امروز، مدیریت داده‌ها به یکی از بزرگترین چالش‌های سازمان‌ها تبدیل شده است. با رشد نمایی حجم داده‌ها، نیاز به یک سیستم فایل قدرتمند، مقیاس‌پذیر و قابل اعتماد بیش از پیش احساس می‌شود. در این میان، ZFS) Zettabyte File System) به عنوان یک سیستم فایل انقلابی و یک مدیریت‌کننده حجم منطقی (Logical Volume Manager) در یک پلتفرم واحد، به عنوان یک راه‌حل پیشرو و قدرتمند ظهور کرده است. ZFS نه تنها مشکلات سیستم‌های فایل سنتی را برطرف می‌کند، بلکه با ویژگی‌های نوآورانه خود، استاندارد جدیدی را در ذخیره‌سازی داده‌ها تعریف می‌کند.

    این محتوای جامع، به شما کمک می‌کند تا به صورت کامل با معماری ZFS، ویژگی‌ها، مزایا، معایب و همچنین کاربردهای آن در محیط‌های NAS) Network-Attached Storage) و SAN) Storage Area Network) آشنا شوید.

    ZFS چیست؟ فراتر از یک سیستم فایل ساده

    ZFS یک سیستم فایل ترکیبی (Hybrid) است که توسط شرکت Sun Microsystems برای سیستم‌عامل Solaris توسعه یافت. ZFS با هدف ارائه قابلیت‌های پیشرفته ذخیره‌سازی، از جمله حفاظت از داده‌ها در برابر فساد، مقیاس‌پذیری نامحدود و مدیریت ساده، طراحی شده است. ZFS فراتر از یک سیستم فایل عمل می‌کند و به عنوان یک مدیریت‌کننده حجم منطقی نیز فعالیت دارد، که این امر نیاز به ابزارهای جداگانه برای مدیریت دیسک‌ها را از بین می‌برد.

    ZFS با ویژگی‌های منحصربه‌فرد خود، خود را از سیستم‌های فایل سنتی مانند ext4 یا NTFS متمایز می‌کند. یکی از مهم‌ترین این ویژگی‌ها، یکپارچگی و حفاظت از داده‌ها است. ZFS از طریق مکانیزم Checksumming، یکپارچگی داده‌ها را به صورت End-to-End تضمین می‌کند. در این روش، قبل از نوشتن داده‌ها، یک Checksum از آن‌ها گرفته می‌شود و در زمان خواندن، مجدداً محاسبه و با مقدار ذخیره‌شده مقایسه می‌گردد. اگر مغایرتی وجود داشته باشد، ZFS داده‌ها را از یک کپی دیگر بازیابی می‌کند و از فساد داده‌ها جلوگیری می‌کند.

    ویژگی کلیدی دیگر ZFS، مقیاس‌پذیری نامحدود آن است. ZFS به صورت ذاتی برای مقیاس‌پذیری طراحی شده است. ظرفیت آن از یک دیسک تا میلیاردها دیسک و تا زیتابایت داده قابل افزایش است. این مقیاس‌پذیری بدون نیاز به پارتیشن‌بندی مجدد یا ساختار‌بندی پیچیده امکان‌پذیر است. علاوه بر این، ZFS از تکنولوژی Copy-on-Write استفاده می‌کند که به آن امکان می‌دهد Snapshotهای بسیار سریع و کارآمدی ایجاد کند.

    کاربرد ZFS در محیط‌های NAS و SAN

    ZFS به دلیل ویژگی‌های قدرتمند خود، به یک انتخاب محبوب در محیط‌های ذخیره‌سازی تحت شبکه تبدیل شده است.

    1. ZFS در محیط‌های NAS

    NAS (Network-Attached Storage) برای اشتراک‌گذاری فایل‌ها در یک شبکه محلی (LAN) استفاده می‌شود. ZFS به عنوان سیستم فایل اصلی در بسیاری از دستگاه‌های NAS، قابلیت‌های پیشرفته‌ای را فراهم می‌کند. ZFS با Checksumming و افزونگی داخلی، از داده‌های کاربران در برابر فساد محافظت می‌کند. این ویژگی برای فایل‌های مهم تجاری و اسناد حساس حیاتی است. همچنین، مدیریت یکپارچه دیسک‌ها در یک استخر، مدیریت فضای ذخیره‌سازی را برای مدیران IT بسیار ساده می‌کند.

    قابلیت Snapshot در ZFS، بکاپ‌گیری را بسیار سریع و کارآمد می‌کند. می‌توان از Snapshotها برای بازیابی سریع داده‌ها در صورت حذف تصادفی یا حمله باج‌افزار استفاده کرد. این Snapshotها فضای بسیار کمی را اشغال می‌کنند و به راحتی قابل بازیابی هستند. علاوه بر این، ZFS از افزونگی داخلی (مانند RAIDZ) پشتیبانی می‌کند که جایگزین RAID Controllerهای سخت‌افزاری می‌شود و از داده‌ها در برابر خرابی دیسک‌ها محافظت می‌کند.

    2. ZFS در محیط‌های SAN

    SAN (Storage Area Network) برای ذخیره‌سازی سطح بلوک و کاربردهای حیاتی مانند پایگاه‌های داده و مجازی‌سازی استفاده می‌شود. ZFS می‌تواند به عنوان یک راه‌حل SAN نرم‌افزارمحور و مقرون‌به‌صرفه عمل کند. ZFS از طریق Caching هوشمند (مانند L2ARC و ZIL) و تکنیک‌های پیشرفته I/O، عملکرد بالایی را برای برنامه‌های حیاتی فراهم می‌کند. این عملکرد برای برنامه‌هایی که به عملیات نوشتن و خواندن سریع نیاز دارند، بسیار مهم است.

    ZFS با ارائه Block Storage از طریق iSCSI یا Fibre Channel، از داده‌های ماشین‌های مجازی محافظت می‌کند. Checksumming در ZFS تضمین می‌کند که داده‌های ماشین‌های مجازی سالم و بدون فساد باشند. این ویژگی برای محیط‌های مجازی‌سازی که در آن‌ها یکپارچگی داده‌ها حیاتی است، بسیار ارزشمند است. همچنین، می‌توان از Snapshot و Clone در ZFS برای ایجاد نسخه‌های لحظه‌ای و قابل استفاده از ماشین‌های مجازی استفاده کرد، که این امر فرآیندهای بکاپ‌گیری و تست را بسیار سریع می‌کند.

    مقایسه ZFS با سیستم‌های فایل سنتی و RAID سخت‌افزاری

    ZFS با ارائه قابلیت‌های پیشرفته و یکپارچه، خود را از سیستم‌های فایل سنتی و راه‌حل‌های RAID سخت‌افزاری متمایز می‌کند. این جدول، تفاوت‌های کلیدی بین این سه فناوری را به وضوح نشان می‌دهد.

    ویژگی

    ZFS

    سیستم‌های فایل سنتی (ext4/NTFS)

    RAID سخت‌افزاری

    یکپارچگی داده‌ها

    بومی و End-to-End از طریق Checksumming

    وابسته به سخت‌افزار (درایو) و بدون محافظت بومی

    وابسته به کنترلر

    مدیریت افزونگی

    نرم‌افزاری (RAIDZ)

    ندارد (وابسته به ابزارهای جانبی)

    سخت‌افزاری، توسط کنترلر اختصاصی

    قابلیت Snapshot و Clone

    بومی، سریع و کارآمد (به دلیل Copy-on-Write)

    کند و وابسته به نرم‌افزار و ابزارهای جانبی

    ندارد

    مقیاس‌پذیری

    نامحدود (تا زیتابایت)

    محدود به اندازه پارتیشن و دیسک

    محدود به کنترلر و تعداد جایگاه‌های دیسک

    مدیریت دیسک

    یکپارچه (Zpool)

    نیازمند مدیریت جداگانه برای هر دیسک

    نیازمند مدیریت جداگانه از طریق نرم‌افزار کنترلر

    نیاز به سخت‌افزار

    سخت‌افزار استاندارد (نیاز به RAM بالا)

    سخت‌افزار استاندارد

    نیازمند کنترلر اختصاصی و گران‌قیمت

    مقاومت در برابر خرابی

    بسیار بالا (خوددرمانی و RAIDZ)

    پایین (وابسته به نرم‌افزار RAID)

    بالا (وابسته به سطح RAID)

    حذف داده‌های تکراری

    بومی (Deduplication)

    ندارد

    ندارد

    فشرده‌سازی داده‌ها

    بومی (پشتیبانی از LZ4, GZIP)

    وابسته به ابزارهای جانبی

    ندارد


    مزایا و معایب استفاده از ZFS

    مانند هر فناوری دیگری، ZFS نیز دارای مزایا و معایب خاص خود است که باید در نظر گرفته شوند.

    مزایای ZFS

    ZFS به دلیل ویژگی‌های قدرتمند خود، مزایای بی‌شماری را برای سازمان‌ها فراهم می‌کند. از جمله این مزایا، حفاظت جامع از داده‌ها است. با Checksumming و خوددرمانی، ZFS یک راهکار بسیار قابل اعتماد برای جلوگیری از فساد داده‌هاست. علاوه بر این، مقیاس‌پذیری و انعطاف‌پذیری آن بی‌نظیر است. ZFS به راحتی مقیاس‌پذیر است و می‌تواند برای کاربردهای مختلف، از سرورهای کوچک تا دیتاسنترهای بزرگ، استفاده شود. همچنین، ZFS هزینه را کاهش می‌دهد، زیرا نیاز به خرید کنترلرهای RAID سخت‌افزاری گران‌قیمت را از بین می‌برد و از سخت‌افزارهای استاندارد استفاده می‌کند. در نهایت، مدیریت ساده ZFS با دستورات یکپارچه، کار را برای مدیران آسان می‌کند.

    معایب ZFS

    با وجود مزایای زیاد، ZFS دارای برخی معایب نیز هست که باید به آن‌ها توجه کرد. اولین و مهم‌ترین عیب، نیاز به منابع سخت‌افزاری زیاد است. ZFS برای عملکرد بهینه، به حافظه رم زیادی نیاز دارد. این نیاز می‌تواند هزینه سخت‌افزاری را بالا ببرد. علاوه بر این، پیچیدگی اولیه راه‌اندازی و پیکربندی ZFS برای کاربران تازه‌کار ممکن است چالش‌برانگیز باشد و وابستگی به سیستم‌عامل نیز یک محدودیت دیگر است. ZFS در ابتدا برای Solaris توسعه یافت و در لینوکس و FreeBSD پشتیبانی می‌شود، اما در ویندوز پشتیبانی بومی ندارد.

    اصول پیشرفته ZFS: L2ARC و ZIL

    برای به حداکثر رساندن عملکرد، ZFS از تکنیک‌های پیشرفته‌ای استفاده می‌کند که به آن اجازه می‌دهد از حافظه‌های پرسرعت مانند SSD به صورت هوشمندانه بهره ببرد.

    1. L2ARC) Level 2 Adaptive Replacement Cache)

    L2ARC یک حافظه کش خواندن (Read Cache) است که به ZFS اجازه می‌دهد تا از یک SSD پرسرعت برای ذخیره داده‌های پرکاربرد استفاده کند. به جای اینکه داده‌ها را از دیسک‌های مکانیکی کندتر بخواند، ZFS می‌تواند آن‌ها را به سرعت از SSD کش L2ARC بازیابی کند و عملکرد را به شکل چشمگیری افزایش دهد. این تکنیک به ویژه برای محیط‌هایی که دارای حجم زیادی از عملیات خواندن هستند، مانند سرورهای وب و پایگاه‌های داده، بسیار کارآمد است و تأخیر در دسترسی به داده‌ها را به شدت کاهش می‌دهد.

    2. ZIL) ZFS Intent Log)

    ZIL یک حافظه کش نوشتن (Write Cache) است که به ZFS اجازه می‌دهد تا عملیات نوشتن همزمان (Synchronous Writes) را با سرعت بالا انجام دهد. ZIL داده‌ها را قبل از نوشتن روی دیسک‌های اصلی، روی یک SSD پرسرعت ذخیره می‌کند و سپس آن‌ها را به صورت دسته‌ای (Batch) به دیسک‌های اصلی منتقل می‌کند. این فرآیند، تأخیر در عملیات نوشتن را به شدت کاهش می‌دهد و برای برنامه‌هایی مانند پایگاه‌های داده که به عملیات نوشتن سریع نیاز دارند، حیاتی است و پایداری داده‌ها را افزایش می‌دهد.

    مقایسه ZFS و RAID Controller سخت‌افزاری

    یکی از مهم‌ترین تفاوت‌های ZFS، نحوه مدیریت افزونگی است. ZFS افزونگی را به صورت نرم‌افزاری (RAIDZ) مدیریت می‌کند، در حالی که RAID Controller سخت‌افزاری افزونگی را به صورت سخت‌افزاری انجام می‌دهد. در RAID Controller سخت‌افزاری، کنترلر تمامی دیسک‌ها را مدیریت می‌کند و به سیستم عامل یک دیسک واحد را نمایش می‌دهد. این امر سرعت بالایی را فراهم می‌کند، اما اگر کنترلر خراب شود، ممکن است دسترسی به داده‌ها با مشکل مواجه شود.

    در مقابل، ZFS افزونگی را به صورت نرم‌افزاری انجام می‌دهد. این امر به ZFS اجازه می‌دهد تا از هر نوع دیسکی استفاده کند و در صورت خرابی یک گره، دیسک‌ها را به یک گره دیگر منتقل کرده و داده‌ها را بازیابی کند. این انعطاف‌پذیری در ZFS بسیار بالاتر است و وابستگی به یک سخت‌افزار خاص را از بین می‌برد.

    انتخاب ZFS برای NAS یا SAN: کدام بهتر است؟

    ZFS می‌تواند در هر دو محیط NAS و SAN استفاده شود، اما انتخاب آن به نیازهای خاص شما بستگی دارد. برای NAS، ZFS به دلیل قابلیت‌های حفاظت از داده‌ها، مدیریت آسان و بکاپ‌گیری کارآمد، یک انتخاب عالی است. این سیستم می‌تواند به راحتی در یک دستگاه NAS پیاده‌سازی شود و تمامی نیازهای مربوط به اشتراک‌گذاری فایل و بکاپ‌گیری را برآورده کند.

    برای SAN، ZFS می‌تواند به عنوان یک راه‌حل نرم‌افزارمحور و مقرون‌به‌صرفه استفاده شود. با استفاده از RBD و iSCSI، ZFS عملکردی مشابه SANهای سخت‌افزاری را ارائه می‌دهد و در عین حال، هزینه‌ها را کاهش می‌دهد. این راه‌حل برای سازمان‌هایی که به دنبال یک SAN با قابلیت‌های پیشرفته و هزینه کمتر هستند، ایده‌آل است.

    تکنیک‌های پیشرفته مدیریت داده در ZFS

    ZFS مجموعه‌ای از تکنیک‌های پیشرفته را برای مدیریت کارآمد داده‌ها ارائه می‌دهد که به بهبود عملکرد و بهینه‌سازی فضای ذخیره‌سازی کمک می‌کند.

    یکی از این تکنیک‌ها، فشرده‌سازی داده‌ها (Data Compression) است. ZFS به صورت بومی از الگوریتم‌های فشرده‌سازی مختلفی مانند LZ4 و GZIP پشتیبانی می‌کند. با فعال کردن فشرده‌سازی، ZFS حجم داده‌های ذخیره‌شده را به شکل چشمگیری کاهش می‌دهد که این امر به صرفه‌جویی در فضای دیسک و افزایش سرعت خواندن و نوشتن منجر می‌شود. این ویژگی به ویژه برای داده‌های متنی و اسناد بسیار کارآمد است.

    تکنیک دیگر، حذف داده‌های تکراری (Deduplication) است. این ویژگی به ZFS اجازه می‌دهد تا بلاک‌های داده تکراری را شناسایی و حذف کند. به جای ذخیره چندین کپی از یک بلوک داده، ZFS تنها یک کپی را ذخیره می‌کند و به آن اشاره می‌کند. این امر به شکل قابل توجهی در فضای ذخیره‌سازی صرفه‌جویی می‌کند، اما نیاز به حافظه رم زیادی دارد و می‌تواند بر عملکرد تأثیر بگذارد. به همین دلیل، استفاده از Deduplication باید با دقت و تنها در صورت نیاز انجام شود.

    حفاظت از داده‌ها با ZFS: RAIDZ و ZFS RAID Levels

    ZFS افزونگی داخلی را با استفاده از سطوح RAIDZ مدیریت می‌کند که جایگزینی نرم‌افزاری برای RAID Controllerهای سخت‌افزاری است. RAIDZ به صورت هوشمندانه افزونگی را در سطح بلوک مدیریت می‌کند و به ZFS اجازه می‌دهد تا از خرابی دیسک‌ها جلوگیری کند.

    سطوح مختلفی از RAIDZ وجود دارد که هر یک از آن‌ها میزان افزونگی متفاوتی را ارائه می‌دهند. RAIDZ1 (مشابه RAID 5) می‌تواند خرابی یک دیسک را تحمل کند. RAIDZ2 (مشابه RAID 6) می‌تواند خرابی همزمان دو دیسک را تحمل کند. و RAIDZ3 می‌تواند خرابی همزمان سه دیسک را تحمل کند. انتخاب سطح RAIDZ مناسب به نیازهای سازمان برای افزونگی و تعداد دیسک‌های موجود بستگی دارد. این سطوح، ZFS را به یک راه‌حل بسیار قابل اعتماد برای حفاظت از داده‌ها تبدیل می‌کنند.

    استفاده از ZFS در محیط‌های رایانش ابری

    ZFS نه تنها برای زیرساخت‌های محلی مناسب است، بلکه می‌تواند در محیط‌های رایانش ابری نیز استفاده شود. بسیاری از ارائه‌دهندگان ابری، سرویس‌هایی را ارائه می‌دهند که امکان استفاده از ZFS را بر روی ماشین‌های مجازی فراهم می‌کنند.

    با استفاده از ZFS در محیط ابری، سازمان‌ها می‌توانند از ویژگی‌های پیشرفته آن مانند Snapshot، Clone و Checksumming برای مدیریت داده‌ها بهره ببرند. این امر به سازمان‌ها اجازه می‌دهد تا با کنترل و انعطاف‌پذیری بیشتری، داده‌های خود را در ابر مدیریت کنند. ZFS همچنین می‌تواند به عنوان یک راه‌حل پشتیبان‌گیری و بازیابی از فاجعه در محیط‌های ابری استفاده شود. با ایجاد یک کلاستر ZFS در ابر و همگام‌سازی داده‌ها با آن، سازمان می‌تواند یک راهکار DR قوی و مقرون‌به‌صرفه را پیاده‌سازی کند.

    ZFS و آینده ذخیره‌سازی

    آینده ذخیره‌سازی به سمت سیستم‌های نرم‌افزارمحور و توزیع‌شده در حال حرکت است و ZFS به عنوان یک پیشرو در این زمینه، نقش مهمی را ایفا می‌کند. ZFS با قابلیت‌های خود در حفاظت از داده‌ها، مقیاس‌پذیری نامحدود و مدیریت ساده، به یک پلتفرم ایده‌آل برای مدیریت داده‌های بزرگ و پیچیده تبدیل شده است.

    ZFS همچنین به صورت مداوم در حال تکامل است. توسعه‌دهندگان در حال افزودن ویژگی‌های جدیدی به آن هستند تا عملکرد و کارایی آن را بهبود بخشند. این تکامل مداوم، ZFS را به یک راه‌حل پایدار برای آینده ذخیره‌سازی داده‌ها تبدیل می‌کند. سازمان‌هایی که به دنبال یک راه‌حل قدرتمند، انعطاف‌پذیر و مقرون‌به‌صرفه هستند، باید ZFS را به عنوان یک گزینه جدی در نظر بگیرند.

    نتیجه‌گیری

    ZFS یک سیستم فایل و مدیریت‌کننده حجم منطقی پیشرو است که با ویژگی‌های نوآورانه خود، استاندارد جدیدی را در ذخیره‌سازی داده‌ها تعریف می‌کند. از حفاظت جامع از داده‌ها و مقیاس‌پذیری نامحدود گرفته تا مدیریت ساده و بکاپ‌گیری کارآمد، ZFS مزایای بی‌شماری را برای سازمان‌ها فراهم می‌کند. با وجود نیاز به منابع سخت‌افزاری بیشتر و منحنی یادگیری شیب‌دار، مزایای ZFS آن را به یک راه‌حل استراتژیک برای محیط‌های NAS و SAN مدرن تبدیل کرده است. با درک دقیق این فناوری، سازمان‌ها می‌توانند زیرساخت ذخیره‌سازی خود را به بهترین نحو ممکن برای آینده آماده کنند.

    سوالات متداول 


    1. آیا ZFS برای کاربران خانگی نیز مناسب است؟
      بله، ZFS برای کاربران خانگی نیز مناسب است، به ویژه اگر به دنبال یک راهکار قابل اعتماد برای ذخیره‌سازی داده‌های مهم مانند عکس‌ها، ویدیوها و اسناد هستند. با این حال، به دلیل نیاز به حافظه رم بیشتر و پیچیدگی اولیه، ممکن است برای کاربران تازه‌کار کمی چالش‌برانگیز باشد. نرم‌افزارهایی مانند TrueNAS (که بر پایه ZFS است)، رابط کاربری گرافیکی ساده‌ای را فراهم می‌کنند که مدیریت ZFS را برای کاربران خانگی و کوچک‌تر آسان می‌کند.

    2. RAIDZ1، RAIDZ2 و RAIDZ3 چه تفاوتی با هم دارند؟
      این سطوح از افزونگی، نسخه‌های نرم‌افزاری RAID در ZFS هستند. تفاوت اصلی آن‌ها در تعداد دیسک‌هایی است که می‌توانند به صورت همزمان خراب شوند. RAIDZ1 می‌تواند خرابی یک دیسک را تحمل کند. RAIDZ2 می‌تواند خرابی همزمان دو دیسک را تحمل کند و RAIDZ3 می‌تواند خرابی همزمان سه دیسک را تحمل کند. انتخاب سطح مناسب به نیاز شما برای افزونگی و تعداد دیسک‌های موجود بستگی دارد.

    3. آیا ZFS با ویندوز سازگار است؟
      خیر، ZFS به صورت بومی با ویندوز سازگار نیست. اگرچه پروژه‌هایی برای ارائه پشتیبانی از ZFS در ویندوز وجود دارد، اما این پشتیبانی کامل و قابل اعتماد نیست. ZFS به صورت کامل در سیستم‌عامل‌های مبتنی بر یونیکس مانند FreeBSD و Linux پشتیبانی می‌شود و برای استفاده در محیط ویندوز، باید از راه‌حل‌های مجازی‌سازی یا از یک دستگاه NAS مبتنی بر ZFS استفاده کرد.

    4. ZFS چگونه از داده‌ها در برابر فساد (Corruption) محافظت می‌کند؟
      ZFS با استفاده از مکانیزم Checksumming، از داده‌ها در برابر فساد محافظت می‌کند. قبل از نوشتن داده‌ها، یک Checksum از آن‌ها گرفته شده و به همراه داده‌ها ذخیره می‌شود. در زمان خواندن، ZFS مجدداً Checksum را محاسبه کرده و با مقدار ذخیره‌شده مقایسه می‌کند. اگر این دو مقدار با هم مطابقت نداشته باشند، ZFS متوجه فساد داده شده و به صورت خودکار داده‌ها را از یک نسخه کپی سالم (در صورت وجود) بازیابی می‌کند. این فرآیند، یکپارچگی داده‌ها را در طول چرخه حیات آن‌ها تضمین می‌کند.

  • مزایا و معایب استفاده از SSD در ذخیره‌سازی سازمانی

    مزایا و معایب استفاده از SSD در ذخیره‌سازی سازمانی

    در دنیای مدرن فناوری اطلاعات، سرعت و کارایی سیستم‌های ذخیره‌سازی به عنوان یک عامل حیاتی برای موفقیت سازمان‌ها شناخته می‌شود. با رشد روزافزون حجم داده‌ها و نیاز به دسترسی لحظه‌ای به آن‌ها، درایوهای حالت جامد (Solid-State Drives) یا SSD به عنوان یک فناوری انقلابی، جایگاه خود را در زیرساخت‌های سازمانی تثبیت کرده‌اند. SSDها با کنار گذاشتن قطعات مکانیکی، عملکردی بی‌نظیر را ارائه می‌دهند که فراتر از هر هارد دیسک مکانیکی (HDD) است.

    این محتوای جامع، به شما کمک می‌کند تا به صورت عمیق با مزایا و معایب استفاده از SSD در محیط‌های ذخیره‌سازی سازمانی آشنا شوید و یک تصمیم آگاهانه برای سرمایه‌گذاری در این فناوری اتخاذ کنید.

    SSD چیست؟ تفاوت با HDD و نحوه عملکرد آن

    SSD یک دستگاه ذخیره‌سازی داده است که از حافظه Flash برای ذخیره داده‌ها استفاده می‌کند. برخلاف هارد دیسک‌های مکانیکی (Hard Disk Drives) یا HDD که از دیسک‌های چرخان و هد‌های خواندن/نوشتن برای دسترسی به داده‌ها استفاده می‌کنند، SSDها هیچ قطعه متحرکی ندارند. این تفاوت اساسی در معماری، مزایای بی‌نظیری را برای SSDها به همراه دارد.

    یک SSD از یک کنترلر و یک یا چند تراشه حافظه NAND Flash تشکیل شده است. کنترلر، مغز متفکر SSD است و وظیفه مدیریت داده‌ها، خواندن و نوشتن، و همچنین بهینه‌سازی عملکرد و عمر درایو را بر عهده دارد. داده‌ها به صورت الکترونیکی در سلول‌های حافظه NAND Flash ذخیره می‌شوند و به دلیل نبود قطعات مکانیکی، دسترسی به آن‌ها بسیار سریع و بدون تأخیر است. این سرعت بی‌سابقه، امکان انجام عملیات‌های ورودی/خروجی (I/O) با سرعت بالا را فراهم می‌کند و برای کاربردهای حساس به عملکرد، حیاتی است.

    مزایای کلیدی استفاده از SSD در محیط‌های سازمانی

    استفاده از SSD در زیرساخت‌های سازمانی، مزایای چشمگیری را در عملکرد، کارایی و قابلیت اطمینان به همراه دارد. این مزایا، SSD را به یک گزینه ایده‌آل برای بسیاری از کاربردهای مدرن تبدیل کرده است.

    1. عملکرد فوق‌العاده و سرعت بی‌نظیر

    اصلی‌ترین و مهم‌ترین مزیت SSDها، عملکرد آن‌هاست. SSDها می‌توانند داده‌ها را با سرعت‌هایی بسیار بالاتر از HDDها بخوانند و بنویسند. این سرعت برای برنامه‌هایی که نیاز به دسترسی لحظه‌ای به داده‌ها دارند، مانند پایگاه‌های داده‌های تراکنشی، حیاتی است و زمان پاسخگویی سیستم را به شکل چشمگیری کاهش می‌دهد.

    علاوه بر سرعت انتقال داده‌ها، SSDها عملیات ورودی/خروجی در ثانیه (IOPS) بسیار بالاتری نسبت به HDDها دارند. این ویژگی برای محیط‌های مجازی‌سازی که چندین ماشین مجازی به صورت همزمان به داده‌ها دسترسی پیدا می‌کنند، بسیار مهم است و به کاهش تأخیر کمک می‌کند. این توانایی در پردازش درخواست‌های I/O متعدد، به بهبود عملکرد کلی دیتاسنتر منجر می‌شود.

    2. قابلیت اطمینان و دوام بالا

    به دلیل نبود قطعات متحرک، SSDها در برابر ضربه و لرزش مقاوم‌تر هستند. HDDها به دلیل داشتن دیسک‌های چرخان و هد‌های مکانیکی، نسبت به ضربه و لرزش بسیار حساس هستند، در حالی که SSDها به دلیل معماری جامد، در برابر این عوامل مقاوم‌ترند. این ویژگی باعث می‌شود SSDها برای استفاده در سرورهای قابل حمل یا محیط‌هایی با لرزش بالا، مناسب باشند.

    علاوه بر این، نرخ خرابی SSDها در مقایسه با HDDها بسیار پایین‌تر است، که به کاهش هزینه‌های نگهداری و افزایش زمان کارکرد سیستم‌ها کمک می‌کند. این قابلیت اطمینان بالا، SSD را به یک انتخاب مطمئن برای ذخیره‌سازی داده‌های حیاتی در محیط‌های سازمانی تبدیل کرده است و ریسک از دست رفتن داده‌ها به دلیل خرابی سخت‌افزاری را کاهش می‌دهد.

    3. مصرف انرژی و گرمای کمتر

    SSDها به دلیل معماری خود، انرژی بسیار کمتری مصرف می‌کنند و گرمای کمتری تولید می‌کنند. مصرف انرژی کمتر به کاهش هزینه‌های برق در دیتاسنترها کمک می‌کند. این امر به ویژه در مقیاس‌های بزرگ، می‌تواند به صرفه‌جویی قابل توجهی در هزینه‌های عملیاتی منجر شود.

    تولید گرمای کمتر نیز یک مزیت بزرگ دیگر است. گرمای کمتر به کاهش هزینه‌های خنک‌سازی در دیتاسنترها منجر می‌شود و عمر مفید تجهیزات دیگر را افزایش می‌دهد. این ویژگی به مدیران IT اجازه می‌دهد تا سیستم‌های فشرده‌تر و پرظرفیت‌تر را در فضای محدود دیتاسنتر طراحی کنند و از حداکثر ظرفیت موجود بهره ببرند.

    4. حجم فیزیکی و وزن کمتر

    SSDها به دلیل ابعاد کوچک و وزن کم، برای استفاده در سرورها و تجهیزات با فضای محدود ایده‌آل هستند. این ویژگی امکان طراحی سیستم‌های فشرده‌تر و پرظرفیت‌تر را فراهم می‌کند. در سرورهای blade و دیگر سیستم‌های فشرده، SSDها فضای کمتری را اشغال می‌کنند و وزن کلی سیستم را کاهش می‌دهند.

    معایب و چالش‌های استفاده از SSD در محیط‌های سازمانی

    با وجود مزایای فراوان، استفاده از SSDها در محیط‌های سازمانی با چالش‌ها و معایبی نیز همراه است که باید به آن‌ها توجه کرد. این معایب، SSD را برای برخی از کاربردها نامناسب می‌سازند.

    1. هزینه بالا

    بزرگ‌ترین مانع در استفاده گسترده از SSDها، هزینه آن‌هاست. هزینه هر گیگابایت فضای ذخیره‌سازی در SSDها بسیار بیشتر از HDDها است. این امر باعث می‌شود که پیاده‌سازی زیرساخت‌های ذخیره‌سازی حجیم با SSD، بسیار پرهزینه باشد و نیازمند سرمایه‌گذاری اولیه سنگین باشد. این هزینه بالا، سازمان‌ها را مجبور به استفاده از استراتژی‌های ترکیبی با HDD می‌کند.

    2. عمر محدود و فرسودگی سلول‌ها

    سلول‌های حافظه NAND Flash دارای تعداد محدودی چرخه خواندن و نوشتن هستند که به مرور زمان فرسوده می‌شوند. این ویژگی به عنوان تعداد محدود چرخه نوشتن (Write Endurance) شناخته می‌شود. پس از رسیدن به این محدودیت، سلول فرسوده شده و غیرقابل استفاده می‌شود. این امر باعث می‌شود که SSDها برای کاربردهایی با حجم بالای عملیات نوشتن، مانند پایگاه‌های داده‌های لاگ، مناسب نباشند.

    کنترلرهای SSD از تکنیک‌های مدیریت پیچیده‌ای مانند Wear Leveling و Garbage Collection برای توزیع یکنواخت عملیات نوشتن و افزایش عمر درایو استفاده می‌کنند. با این حال، حتی با این تکنیک‌ها نیز، عمر SSDها محدود است و باید به صورت منظم وضعیت آن‌ها بررسی شود.

    3. چالش‌های بازیابی داده‌ها

    بازیابی داده‌ها از یک SSD خراب، بسیار پیچیده‌تر از یک HDD خراب است. در یک HDD خراب، ممکن است بتوان با استفاده از ابزارهای تخصصی، داده‌ها را از دیسک‌های فیزیکی بازیابی کرد. اما در یک SSD خراب، این امکان وجود ندارد و فرآیند بازیابی داده‌ها از یک SSD خراب، نیازمند ابزارها و تخصص خاصی است که در دسترس همگان نیست.

    مقایسه SSD و HDD در محیط‌های سازمانی

    این جدول، یک مقایسه جامع بین SSD و HDD را در زمینه کاربردهای سازمانی ارائه می‌دهد و به شما در تصمیم‌گیری کمک می‌کند.

    ویژگی SSD (Solid-State Drive) HDD (Hard Disk Drive)
    سرعت بسیار بالا متوسط
    IOPS بسیار بالا پایین
    هزینه به ازای گیگابایت بالا پایین
    مقاومت در برابر ضربه بالا پایین
    مصرف انرژی پایین بالا
    تولید گرما پایین بالا
    دوام محدود (تعداد چرخه نوشتن) نامحدود (وابسته به عمر قطعات)
    بازیابی داده‌ها دشوار و پیچیده نسبتاً آسان‌تر
    کاربرد اصلی برنامه‌های حیاتی، پایگاه داده، مجازی‌سازی ذخیره‌سازی حجیم، آرشیو داده‌ها


    کاربرد SSD در استراتژی‌های ذخیره‌سازی سازمانی

    استفاده از SSD به صورت هوشمندانه و بهینه، می‌تواند عملکرد زیرساخت را به شکل چشمگیری بهبود بخشد. پیاده‌سازی این استراتژی‌ها، به سازمان‌ها اجازه می‌دهد تا از مزایای SSDها بهره ببرند و در عین حال، هزینه‌ها را مدیریت کنند.

    1. ذخیره‌سازی چندلایه (Tiered Storage)

    در این استراتژی، از انواع مختلف رسانه‌های ذخیره‌سازی بر اساس میزان دسترسی و اهمیت داده‌ها استفاده می‌شود. لایه اول (Tier 1) شامل SSDهای پرسرعت برای داده‌های پرکاربرد (Hot Data) مانند پایگاه‌های داده و برنامه‌های حیاتی است. لایه دوم (Tier 2) شامل HDDهای با سرعت متوسط برای داده‌های کمتر استفاده شده (Warm Data) است. در نهایت، لایه سوم (Tier 3) شامل HDDهای با ظرفیت بالا برای داده‌های آرشیوی (Cold Data) است. این استراتژی به سازمان اجازه می‌دهد تا از فضای ذخیره‌سازی گران‌قیمت خود به صورت بهینه استفاده کند.

    2. کش‌کردن (Caching)

    SSDها می‌توانند به عنوان حافظه کش برای HDDها در سیستم‌های ذخیره‌سازی هیبریدی استفاده شوند. در این روش، SSDها به عنوان یک بافر موقت برای داده‌های پرکاربرد عمل می‌کنند. کش خواندن (Read Cache) داده‌های پرکاربرد را به صورت موقت در SSD ذخیره می‌کند تا به سرعت قابل بازیابی باشند. کش نوشتن (Write Cache) داده‌ها را ابتدا روی SSD نوشته و سپس به HDD منتقل می‌کند تا تأخیر در عملیات نوشتن کاهش یابد.

    تکنولوژی‌های نوین SSD و آینده ذخیره‌سازی

    تکنولوژی SSD به صورت مداوم در حال تکامل است و هر روز با نوآوری‌های جدیدی روبرو هستیم. این نوآوری‌ها، SSD را به یک راه‌حل جذاب‌تر و مقرون‌به‌صرفه‌تر برای محیط‌های سازمانی تبدیل می‌کنند.

    1. NAND Flash 3D

    تکنولوژی NAND Flash 3D به تولیدکنندگان اجازه می‌دهد تا سلول‌های حافظه را به صورت عمودی روی یکدیگر قرار دهند. این امر ظرفیت درایوها را به شکل چشمگیری افزایش می‌دهد و هزینه به ازای هر گیگابایت را کاهش می‌دهد. NAND 3D به تولید SSDهای با ظرفیت بالاتر و قیمت مناسب‌تر منجر شده است که آن‌ها را برای کاربردهای ذخیره‌سازی حجیم نیز مناسب می‌کند.

    2. NVMe (Non-Volatile Memory Express)

    NVMe یک پروتکل جدید است که به SSDها اجازه می‌دهد تا از مزایای سرعت باس PCI Express استفاده کنند. NVMe تأخیر را به شدت کاهش می‌دهد و عملکرد SSDها را به حداکثر می‌رساند. این پروتکل برای برنامه‌هایی که نیاز به بالاترین سرعت ممکن دارند، مانند هوش مصنوعی و تحلیل داده‌های بزرگ، حیاتی است و به SSD اجازه می‌دهد تا به پتانسیل کامل خود دست یابد.

    انتخاب SSD مناسب برای کاربردهای سازمانی

    انتخاب یک SSD مناسب برای محیط سازمانی، نیازمند در نظر گرفتن معیارهای کلیدی است. یک تصمیم آگاهانه می‌تواند بهینه‌سازی عملکرد و هزینه را به همراه داشته باشد.

    1. نوع حافظه NAND Flash

    نوع حافظه NAND Flash، بر ظرفیت و دوام درایو تأثیر مستقیم دارد. SLC (Single-Level Cell) هر سلول یک بیت داده را ذخیره می‌کند و بالاترین سرعت و دوام را دارد، اما گران‌ترین است. MLC (Multi-Level Cell) هر سلول دو بیت داده را ذخیره می‌کند و سرعت و دوام متوسطی دارد. TLC (Triple-Level Cell) هر سلول سه بیت داده را ذخیره می‌کند و ارزان‌ترین و پرظرفیت‌ترین است، اما دوام کمتری دارد. در نهایت، QLC (Quad-Level Cell) هر سلول چهار بیت داده را ذخیره می‌کند و ارزان‌ترین است و برای ذخیره‌سازی داده‌های آرشیوی مناسب است.

    2. دوام و DWPD (Drive Writes Per Day)

    DWPD یک شاخص برای سنجش دوام یک SSD در محیط سازمانی است. DWPD به معنای تعداد دفعاتی است که می‌توان کل ظرفیت درایو را در طول یک روز و در طول عمر مفید آن، بازنویسی کرد. برای برنامه‌هایی که نیاز به نوشتن مکرر دارند، باید SSDهایی با DWPD بالاتر انتخاب شوند. این شاخص به سازمان کمک می‌کند تا SSD مناسبی را برای کاربردهای خاص خود، مانند پایگاه‌های داده یا محیط‌های مجازی‌سازی، انتخاب کند.

    نقش SSD در کاهش هزینه‌ها در بلندمدت

    اگرچه هزینه اولیه SSDها بالا است، اما در بلندمدت می‌توانند به کاهش هزینه‌های کلی دیتاسنتر کمک کنند. این کاهش هزینه از چند جنبه قابل بررسی است. اول، مصرف انرژی کمتر SSDها به کاهش هزینه‌های برق و خنک‌سازی در دیتاسنترها منجر می‌شود. این صرفه‌جویی در مقیاس‌های بزرگ می‌تواند قابل توجه باشد.

    علاوه بر این، سرعت بالای SSDها به سازمان‌ها اجازه می‌دهد تا با تعداد کمتری سرور و سیستم، به همان سطح از عملکرد دست یابند. این امر به کاهش هزینه‌های سخت‌افزاری، فضای اشغال شده و هزینه‌های مدیریتی کمک می‌کند. به عبارت دیگر، SSDها به سازمان‌ها امکان می‌دهند تا با سرمایه‌گذاری کمتر در زیرساخت، به کارایی بیشتری دست پیدا کنند.

    SSD و مقاومت در برابر بلایا و خرابی‌ها

    SSDها به دلیل ماهیت جامد خود، مقاومت بیشتری در برابر بلایای فیزیکی دارند. به دلیل نبود قطعات متحرک، آن‌ها در برابر لرزش و ضربه مقاوم‌تر هستند. این ویژگی باعث می‌شود که SSDها برای استفاده در محیط‌های صنعتی یا مکان‌هایی که با خطرات فیزیکی مواجه هستند، مناسب باشند.

    همچنین، نرخ خرابی پایین‌تر SSDها، به افزایش پایداری سیستم‌ها کمک می‌کند. با این حال، در صورت خرابی کامل یک SSD، بازیابی اطلاعات بسیار دشوار است. به همین دلیل، پیاده‌سازی یک استراتژی پشتیبان‌گیری قوی و قابل اعتماد برای حفاظت از داده‌ها در برابر از دست رفتن، حیاتی است.

    آینده SSD در ذخیره‌سازی سازمانی

    آینده SSD در ذخیره‌سازی سازمانی روشن به نظر می‌رسد. با کاهش مداوم قیمت‌ها و افزایش ظرفیت‌ها، SSDها به یک استاندارد صنعتی برای تمامی کاربردهای حیاتی در دیتاسنترها تبدیل خواهند شد. تکنولوژی‌های جدید مانند QLC NAND امکان تولید SSDهای با ظرفیت بالا و قیمت بسیار مناسب را فراهم می‌کنند که آن‌ها را برای ذخیره‌سازی داده‌های آرشیوی نیز مناسب می‌کند.

    همچنین، انتظار می‌رود که پروتکل‌های جدید مانند NVMe-oF (NVMe over Fabrics) که به SSDها اجازه می‌دهند از طریق شبکه با سرعت بسیار بالا به سرورها متصل شوند، عملکرد سیستم‌های ذخیره‌سازی را به شکل چشمگیری افزایش دهند. این فناوری به سازمان‌ها اجازه می‌دهد تا از مزایای سرعت SSDها در یک محیط شبکه‌ای و توزیع‌شده بهره ببرند و بهینه‌سازی عملکرد و هزینه را در یکجا داشته باشند.

    نتیجه‌گیری

    SSDها با ارائه عملکرد بی‌نظیر، قابلیت اطمینان بالا و مصرف انرژی کمتر، به یک فناوری حیاتی در ذخیره‌سازی سازمانی تبدیل شده‌اند. با این حال، هزینه بالا و عمر محدود سلول‌های حافظه، چالش‌هایی را نیز به همراه دارند. با پیاده‌سازی استراتژی‌های هوشمندانه مانند ذخیره‌سازی چندلایه و کش‌کردن، سازمان‌ها می‌توانند از مزایای SSDها بهره ببرند و در عین حال، هزینه‌ها را بهینه کنند. با تکامل فناوری و کاهش قیمت‌ها، SSDها به یک استاندارد صنعتی برای تمامی کاربردهای حیاتی در دیتاسنترها تبدیل خواهند شد.

    سوالات متداول 

    1. آیا SSD برای ذخیره‌سازی داده‌های حجیم آرشیوی مناسب است؟
      در گذشته، به دلیل هزینه بالای SSDها، استفاده از آن‌ها برای ذخیره‌سازی داده‌های حجیم آرشیوی مقرون‌به‌صرفه نبود. اما با معرفی نسل جدید SSDها با حافظه QLC NAND، این وضعیت در حال تغییر است. SSDهای QLC ظرفیت بسیار بالایی دارند و هزینه به ازای هر گیگابایت آن‌ها پایین‌تر است، که آن‌ها را به یک گزینه مناسب برای ذخیره‌سازی داده‌های آرشیوی تبدیل می‌کند. با این حال، HDDها همچنان ارزان‌ترین گزینه برای این کاربرد هستند.
    2. چگونه می‌توان عمر مفید SSD را در محیط سازمانی افزایش داد؟
      برای افزایش عمر مفید SSDها، باید به چند نکته کلیدی توجه کرد. اول، از SSDهای با دوام بالاتر (با شاخص DWPD بالاتر) برای کاربردهایی که نیاز به نوشتن مکرر دارند، استفاده کنید. دوم، از تکنولوژی‌هایی مانند Wear Leveling و Garbage Collection که توسط کنترلر SSD به صورت خودکار مدیریت می‌شوند، اطمینان حاصل کنید. سوم، می‌توانید از کش‌کردن (Caching) خواندن و نوشتن استفاده کنید تا عملیات نوشتن غیرضروری روی SSD کاهش یابد.
    3. آیا بازیابی اطلاعات از SSD خراب امکان‌پذیر است؟
      بازیابی اطلاعات از SSD خراب، بسیار دشوارتر و پیچیده‌تر از HDD است. در یک HDD، ممکن است بتوان با استفاده از ابزارهای تخصصی، داده‌ها را از دیسک‌های فیزیکی بازیابی کرد. اما در یک SSD خراب، این امکان وجود ندارد و فرآیند بازیابی نیازمند تخصص و ابزارهای بسیار خاصی است. به همین دلیل، پیاده‌سازی یک استراتژی پشتیبان‌گیری قوی و منظم برای حفاظت از داده‌ها در SSDها، حیاتی است.
    4. کدام پروتکل برای اتصال SSDها در یک SAN مناسب‌تر است؟
      برای دستیابی به حداکثر عملکرد از SSDها در یک شبکه SAN، استفاده از پروتکل NVMe (Non-Volatile Memory Express) توصیه می‌شود. NVMe به SSDها اجازه می‌دهد تا از سرعت بالای باس PCI Express بهره ببرند و تأخیر را به شدت کاهش دهند. پروتکل‌های قدیمی‌تر مانند SAS و SATA نیز برای اتصال SSDها مناسب هستند، اما NVMe به دلیل بهینه‌سازی برای معماری SSD، عملکرد بهتری را ارائه می‌دهد.


  • تفاوت ذخیره‌سازی File-Level، Block-Level و Object-Level

    تفاوت ذخیره‌سازی File-Level، Block-Level و Object-Level

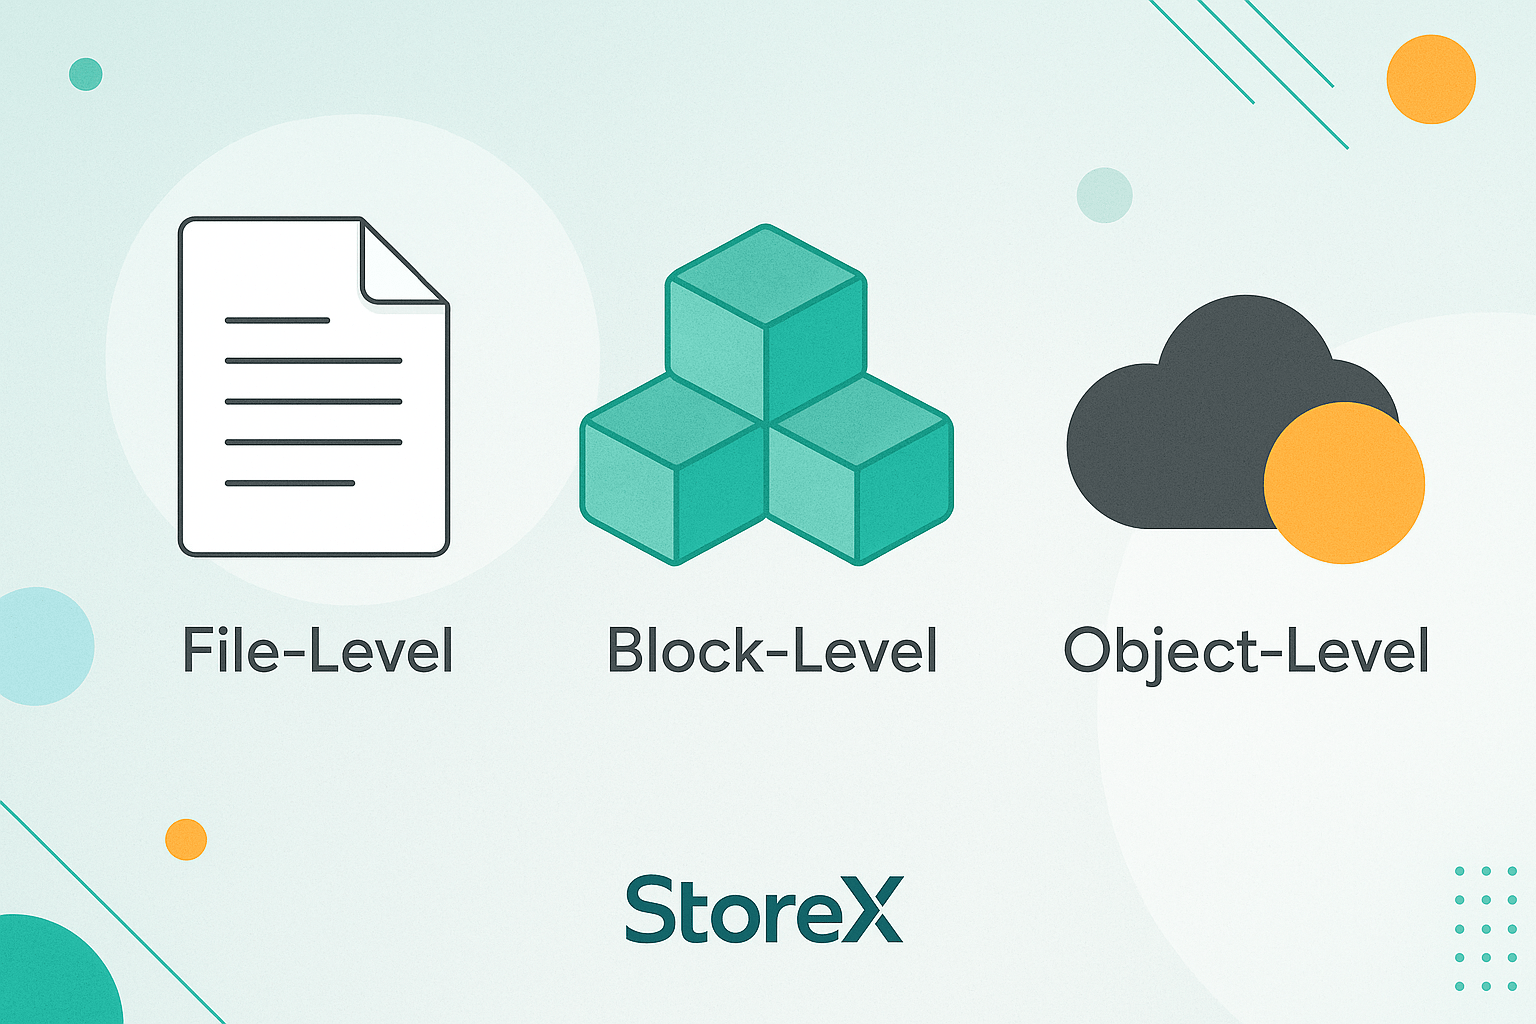
    در دنیای امروز، داده‌ها به عنوان شریان حیاتی هر سازمان شناخته می‌شوند. با رشد فزاینده حجم و انواع داده‌ها، انتخاب راهکار مناسب برای ذخیره‌سازی، یک تصمیم استراتژیک و حیاتی است. سه رویکرد اصلی برای مدیریت داده‌ها در زیرساخت‌های فناوری اطلاعات وجود دارد: ذخیره‌سازی سطح فایل (File-Level)، ذخیره‌سازی سطح بلوک (Block-Level) و ذخیره‌سازی شیءمحور (Object-Level). هر یک از این روش‌ها، دارای معماری، مزایا، معایب و کاربردهای خاص خود هستند و شناخت دقیق تفاوت‌های آن‌ها، به شما کمک می‌کند تا بهترین راهکار را برای نیازهای کسب‌وکار خود انتخاب کنید.

    این محتوای جامع، به صورت عمیق به بررسی این سه مدل ذخیره‌سازی از جنبه‌های مختلفی مانند نحوه دسترسی، پروتکل‌ها، مقیاس‌پذیری و کاربردهای آن‌ها می‌پردازد.

    ذخیره‌سازی سطح فایل (File-Level Storage)

    ذخیره‌سازی سطح فایل ساده‌ترین و آشناترین روش ذخیره‌سازی است که از یک سیستم فایل سلسله‌مراتبی (Hierarchical) برای سازماندهی داده‌ها استفاده می‌کند. در این روش، داده‌ها به صورت فایل و پوشه (Folder) سازماندهی می‌شوند و کاربران با استفاده از مسیرهای فایل (File Path) به آن‌ها دسترسی پیدا می‌کنند. این مدل، در واقع همان چیزی است که ما در استفاده روزمره از کامپیوترها، مانند ذخیره فایل‌ها در دایرکتوری‌ها، با آن آشنا هستیم.

    در ذخیره‌سازی سطح فایل، یک دستگاه ذخیره‌سازی، مانند NAS) Network-Attached Storage)، به شبکه متصل می‌شود و به عنوان یک سرور فایل عمل می‌کند. این سرور، فایل‌ها و پوشه‌ها را به اشتراک می‌گذارد و به کاربران اجازه می‌دهد تا از طریق شبکه به آن‌ها دسترسی داشته باشند. در این مدل، مسئولیت مدیریت فایل‌ها و دایرکتوری‌ها بر عهده سرور ذخیره‌سازی است. این سرور به درخواست‌های کاربران برای ایجاد، ویرایش، حذف یا دسترسی به فایل‌ها پاسخ می‌دهد و تمامی این فرآیندها در لایه نرم‌افزاری سرور انجام می‌شود.

    پروتکل‌های اصلی که در ذخیره‌سازی سطح فایل استفاده می‌شوند، SMB/CIFS) Server Message Block) برای محیط‌های ویندوز و NFS) Network File System) برای محیط‌های یونیکس و لینوکس هستند. این پروتکل‌ها به کاربران امکان می‌دهند تا به صورت همزمان به فایل‌ها دسترسی پیدا کرده و آن‌ها را ویرایش کنند. به همین دلیل، ذخیره‌سازی سطح فایل برای محیط‌های کاری و اشتراک‌گذاری فایل‌ها، یک راه‌حل ایده‌آل است. این روش به دلیل سادگی و کاربری آسان، بسیار محبوب و پرکاربرد است.

    ذخیره‌سازی سطح بلوک (Block-Level Storage)

    ذخیره‌سازی سطح بلوک یک روش پیچیده‌تر و پرسرعت برای ذخیره‌سازی داده‌هاست. در این روش، داده‌ها به صورت بلوک‌های خام (Raw Blocks) سازماندهی می‌شوند و هیچ ساختار فایل یا پوشه‌ای در سطح ذخیره‌سازی وجود ندارد. سیستم عامل سرور، این بلوک‌ها را به عنوان یک دیسک محلی می‌بیند و وظیفه مدیریت فایل‌ها و دایرکتوری‌ها را خود بر عهده می‌گیرد. این رویکرد، دسترسی مستقیم و بسیار سریعی به داده‌ها را فراهم می‌کند که برای کاربردهای حساس به عملکرد، حیاتی است.

    در ذخیره‌سازی سطح بلوک، یک سیستم ذخیره‌سازی، مانند SAN) Storage Area Network)، از طریق یک شبکه اختصاصی و پرسرعت، به سرورها متصل می‌شود. داده‌ها به صورت بلوک‌های مجزا و بدون هیچ‌گونه متادیتای اضافی به سرورها ارائه می‌شوند. سیستم عامل سرور، این بلوک‌ها را به عنوان یک هارد دیسک محلی شناسایی می‌کند و بر روی آن‌ها یک سیستم فایل (مانند ext4 یا NTFS) ایجاد می‌کند. این فرآیند، دسترسی بسیار سریع و مستقیم به داده‌ها را فراهم می‌کند، زیرا هیچ لایه نرم‌افزاری اضافی برای مدیریت فایل‌ها در مسیر انتقال وجود ندارد.

    پروتکل‌های اصلی که در ذخیره‌سازی سطح بلوک استفاده می‌شوند، iSCSI (Internet Small Computer System Interface) و Fibre Channel) FC) هستند. iSCSI از زیرساخت شبکه اترنت استاندارد استفاده می‌کند، در حالی که Fibre Channel از یک شبکه اختصاصی و پرسرعت با کابل‌های فیبر نوری بهره می‌برد. هر دوی این پروتکل‌ها، دسترسی سطح بلوک را فراهم می‌کنند که برای کاربردهایی مانند پایگاه‌های داده، محیط‌های مجازی‌سازی و برنامه‌هایی که به حجم بالای I/O نیاز دارند، ایده‌آل است.

    ذخیره‌سازی شیءمحور (Object-Level Storage)

    ذخیره‌سازی شیءمحور یک رویکرد نوین برای مدیریت داده‌های غیرساخت‌یافته (Unstructured Data) است. در این روش، داده‌ها به صورت “شیء” (Object) ذخیره می‌شوند. هر شیء شامل خود داده‌ها، یک شناسه منحصر به فرد و متادیتای توصیفی است. این مدل بر خلاف ذخیره‌سازی سطح فایل و بلوک، از یک ساختار سلسله‌مراتبی استفاده نمی‌کند و داده‌ها را در یک فضای ذخیره‌سازی تخت (Flat) نگهداری می‌کند.

    در ذخیره‌سازی شیءمحور، داده‌ها به صورت یک شیء واحد در یک مخزن ذخیره‌سازی بزرگ قرار می‌گیرند. هر شیء دارای یک شناسه منحصر به فرد است که به عنوان کلید (Key) برای دسترسی به آن استفاده می‌شود. متادیتای توصیفی نیز اطلاعاتی مانند تاریخ ایجاد، نوع فایل و سایر مشخصات را در خود ذخیره می‌کند. این متادیتا، جستجوی داده‌ها را بسیار ساده می‌کند، زیرا می‌توان با استفاده از ویژگی‌های متادیتا، شیء مورد نظر را به سرعت پیدا کرد. این رویکرد برای مدیریت حجم عظیمی از داده‌های غیرساخت‌یافته بسیار کارآمد است.

    پروتکل‌های اصلی برای دسترسی به ذخیره‌سازی شیءمحور، API‌های RESTful هستند که از طریق اینترنت به داده‌ها دسترسی پیدا می‌کنند. محبوب‌ترین این APIها، Amazon S3) Simple Storage Service) است که به یک استاندارد صنعتی تبدیل شده است. این رویکرد، امکان دسترسی به داده‌ها را از هر مکان و در هر زمانی فراهم می‌کند و به همین دلیل، برای محیط‌های ابری و رایانش توزیع‌شده بسیار مناسب است.

    مقایسه جامع سه روش ذخیره‌سازی

    برای درک بهتر تفاوت‌های بین ذخیره‌سازی سطح فایل، بلوک و شیءمحور، می‌توان آن‌ها را بر اساس معیارهای کلیدی مقایسه کرد. ذخیره‌سازی سطح فایل با دسترسی از طریق مسیرهای فایل، ساده‌ترین روش است و برای اشتراک‌گذاری فایل‌ها و بکاپ‌گیری در شبکه‌های محلی مناسب است. این روش هزینه پایینی دارد و مدیریت آن آسان است، اما مقیاس‌پذیری و عملکرد آن محدود است. دستگاه‌های NAS از این روش استفاده می‌کنند.

    در مقابل، ذخیره‌سازی سطح بلوک با ارائه بلوک‌های خام داده، بالاترین عملکرد و کمترین تأخیر را فراهم می‌کند. این روش برای کاربردهای حیاتی مانند پایگاه‌های داده و محیط‌های مجازی‌سازی ضروری است. با این حال، راه‌اندازی و مدیریت آن پیچیده و گران‌قیمت است. دستگاه‌های SAN از این روش استفاده می‌کنند و برای دیتاسنترهای بزرگ ایده‌آل هستند.

    در نهایت، ذخیره‌سازی شیءمحور با ساختار تخت و استفاده از API، برای مقیاس‌پذیری نامحدود و مدیریت داده‌های غیرساخت‌یافته طراحی شده است. این روش هزینه پایینی دارد و برای محیط‌های ابری بسیار مناسب است، اما عملکرد آن به دلیل تأخیر در شبکه، پایین‌تر از دو روش دیگر است. هر سه روش برای کاربردهای متفاوتی بهینه شده‌اند و یک سازمان ممکن است برای پاسخ به تمامی نیازهای خود، از هر سه روش به صورت ترکیبی استفاده کند.

    انتخاب راهکار مناسب؛ تصمیم‌گیری بر اساس نیاز

    انتخاب بین این سه روش ذخیره‌سازی به نیازهای خاص سازمان شما بستگی دارد. هر یک از این روش‌ها برای سناریوهای متفاوتی بهینه شده‌اند و یک راهکار جامع ممکن است شامل استفاده از هر سه روش در یک معماری ترکیبی باشد.

    1. چه زمانی از ذخیره‌سازی سطح فایل استفاده کنیم؟

    ذخیره‌سازی سطح فایل برای محیط‌هایی که نیاز به اشتراک‌گذاری فایل‌ها و پوشه‌ها دارند، ایده‌آل است. برای مثال، در محیط‌های اداری و دفاتر کار، از این روش برای اشتراک‌گذاری اسناد، فایل‌های پروژه‌ها و فایل‌های چندرسانه‌ای در یک شبکه محلی استفاده می‌شود. همچنین، برای بکاپ‌گیری از سرورها و کامپیوترهای کاربران و آرشیو داده‌ها در یک سیستم NAS، این روش به دلیل سادگی و هزینه پایین، یک گزینه عالی است. در نهایت، برای میزبانی فایل‌های استاتیک وب‌سایت‌ها و ارائه خدمات فایل به کاربران، ذخیره‌سازی سطح فایل بسیار کارآمد است.

    2. چه زمانی از ذخیره‌سازی سطح بلوک استفاده کنیم؟

    ذخیره‌سازی سطح بلوک برای کاربردهای حیاتی که به عملکرد بالا و تأخیر پایین نیاز دارند، ضروری است. این روش برای پایگاه‌های داده‌های تراکنشی و سیستم‌های مالی که نیاز به حجم بالای عملیات I/O دارند، ایده‌آل است. همچنین، در محیط‌های مجازی‌سازی، ذخیره‌سازی سطح بلوک برای ذخیره‌سازی ماشین‌های مجازی (VMs) که چندین VM به صورت همزمان به یک فضای ذخیره‌سازی مشترک دسترسی پیدا می‌کنند، استفاده می‌شود. در نهایت، این روش برای زیرساخت‌های اصلی دیتاسنتر که به عملکرد فوق‌العاده و قابلیت اطمینان بالا نیاز دارند، ضروری است.

    3. چه زمانی از ذخیره‌سازی شیءمحور استفاده کنیم؟

    ذخیره‌سازی شیءمحور برای مدیریت داده‌های حجیم و غیرساخت‌یافته در مقیاس بزرگ مناسب است. این روش برای رایانش ابری و بکاپ ابری، برای ذخیره‌سازی داده‌ها در ابر و بکاپ گرفتن از داده‌ها در ابر استفاده می‌شود. همچنین، برای تحلیل داده‌های بزرگ (Big Data)، این روش برای ذخیره‌سازی داده‌های خام و غیرساخت‌یافته در حجم‌های پتابایت برای تحلیل، ایده‌آل است. در نهایت، برای آرشیو و بایگانی داده‌های قدیمی و کمتر استفاده شده به صورت مقرون‌به‌صرفه، ذخیره‌سازی شیءمحور بهترین گزینه است.

    نقش مجازی‌سازی در ذخیره‌سازی سطح بلوک و فایل

    مجازی‌سازی به عنوان یک فناوری کلیدی، نقش مهمی در نحوه استفاده از ذخیره‌سازی سطح بلوک و فایل ایفا می‌کند. در محیط‌های مجازی‌سازی، ماشین‌های مجازی برای ذخیره داده‌های خود به یک فضای ذخیره‌سازی نیاز دارند. در این حالت، ذخیره‌سازی سطح بلوک به عنوان یک راهکار ایده‌آل برای ذخیره‌سازی دیسک‌های مجازی ماشین‌ها عمل می‌کند.

    با استفاده از یک SAN، می‌توان فضای ذخیره‌سازی سطح بلوک را به Hypervisor سرورها (مانند VMware ESXi) ارائه داد. Hypervisor سپس این بلوک‌ها را به عنوان دیسک‌های مجازی به ماشین‌های مجازی اختصاص می‌دهد. این رویکرد به دلیل عملکرد فوق‌العاده و تأخیر پایین، برای محیط‌های مجازی‌سازی حیاتی است. در مقابل، ذخیره‌سازی سطح فایل نیز می‌تواند برای ذخیره‌سازی فایل‌های پشتیبان یا داده‌های مشترک بین ماشین‌های مجازی استفاده شود، اما برای دیسک‌های اصلی ماشین‌ها، ذخیره‌سازی سطح بلوک ارجحیت دارد.

    چالش‌ها و ملاحظات در پیاده‌سازی هر یک از روش‌ها

    پیاده‌سازی هر یک از این روش‌های ذخیره‌سازی با چالش‌ها و ملاحظات خاص خود همراه است که باید به آن‌ها توجه کرد. در ذخیره‌سازی سطح فایل، چالش اصلی، مقیاس‌پذیری و عملکرد است. با افزایش تعداد کاربران و حجم داده‌ها، عملکرد سیستم NAS ممکن است کاهش یابد و به یک گلوگاه تبدیل شود. برای رفع این مشکل، باید از سخت‌افزارهای قدرتمندتر و شبکه‌های پرسرعت استفاده کرد.

    در ذخیره‌سازی سطح بلوک، چالش اصلی، پیچیدگی و هزینه است. راه‌اندازی یک SAN نیازمند تخصص فنی و سرمایه‌گذاری سنگین در تجهیزات گران‌قیمت است. علاوه بر این، مدیریت یک SAN نیز پیچیده است و نیازمند تیم‌های متخصص است. در نهایت، در ذخیره‌سازی شیءمحور، چالش اصلی، تأخیر در دسترسی به داده‌ها و عدم ویرایش مستقیم فایل‌ها است. این روش برای برنامه‌هایی که نیاز به دسترسی لحظه‌ای و ویرایش مستقیم دارند، مناسب نیست.

    آینده ذخیره‌سازی: از معماری‌های ترکیبی تا نرم‌افزارمحور

    آینده ذخیره‌سازی به سمت معماری‌های ترکیبی و نرم‌افزارمحور در حال حرکت است. با توجه به اینکه هر یک از این روش‌ها دارای نقاط قوت و ضعف خاص خود هستند، سازمان‌ها به سمت استفاده از یک معماری ترکیبی گرایش پیدا کرده‌اند که از مزایای هر سه روش بهره می‌برد.

    در این معماری‌ها، از ذخیره‌سازی سطح بلوک برای برنامه‌های حیاتی، از ذخیره‌سازی سطح فایل برای اشتراک‌گذاری فایل‌ها و از ذخیره‌سازی شیءمحور برای آرشیو و داده‌های حجیم استفاده می‌شود. علاوه بر این، با ظهور فناوری‌هایی مانند ذخیره‌سازی تعریف‌شده با نرم‌افزار (Software-Defined Storage)، مدیریت تمامی این راهکارها از طریق یک پلتفرم نرم‌افزاری واحد امکان‌پذیر شده است. این رویکرد به سازمان‌ها اجازه می‌دهد تا با انعطاف‌پذیری بیشتری به نیازهای متغیر خود پاسخ دهند و بهینه‌سازی عملکرد و هزینه را در یکجا داشته باشند.

    نتیجه‌گیری

    ذخیره‌سازی سطح فایل، بلوک و شیءمحور، سه رویکرد اصلی در مدیریت داده‌ها هستند که هر یک برای کاربردهای متفاوتی طراحی شده‌اند. ذخیره‌سازی سطح فایل با سادگی خود، برای اشتراک‌گذاری فایل‌ها ایده‌آل است. ذخیره‌سازی سطح بلوک با عملکرد فوق‌العاده خود، برای کاربردهای حیاتی مانند پایگاه‌های داده و مجازی‌سازی ضروری است. در نهایت، ذخیره‌سازی شیءمحور با مقیاس‌پذیری نامحدود، برای مدیریت داده‌های حجیم و غیرساخت‌یافته در محیط‌های ابری مناسب است.

    در یک معماری مدرن، سازمان‌ها اغلب از یک رویکرد ترکیبی برای بهره‌گیری از مزایای هر سه روش استفاده می‌کنند. با درک دقیق تفاوت‌های این سه مدل، می‌توانید یک استراتژی ذخیره‌سازی قوی و کارآمد برای آینده کسب‌وکار خود طراحی کنید.

    سوالات متداول 

    1. برای ذخیره‌سازی فایل‌های عمومی در یک دفتر کار، کدام روش مناسب‌تر است؟
      برای ذخیره‌سازی فایل‌های عمومی در یک دفتر کار، ذخیره‌سازی سطح فایل بهترین گزینه است. این روش به دلیل سادگی، کاربری آسان و هزینه پایین، برای اشتراک‌گذاری فایل‌ها و اسناد بین کاربران در یک شبکه محلی بسیار مناسب است. دستگاه‌های NAS از این روش استفاده می‌کنند و راه‌اندازی و مدیریت آن‌ها بسیار ساده است.
    2. چرا برای پایگاه‌های داده از ذخیره‌سازی سطح بلوک استفاده می‌شود؟
      پایگاه‌های داده برای عملکرد بهینه، نیاز به دسترسی بسیار سریع و تأخیر پایین به داده‌ها دارند. ذخیره‌سازی سطح بلوک به دلیل ارائه بلوک‌های خام داده، دسترسی مستقیم و پرسرعتی را فراهم می‌کند که تأخیر را به حداقل می‌رساند. این امر باعث می‌شود که عملیات‌های ورودی/خروجی (I/O) در پایگاه‌های داده با سرعت بسیار بالا انجام شوند و عملکرد کلی سیستم بهبود یابد.
    3. چه زمانی باید از ذخیره‌سازی شیءمحور استفاده کرد؟
      ذخیره‌سازی شیءمحور برای مدیریت حجم عظیمی از داده‌های غیرساخت‌یافته (مانند تصاویر، ویدیوها و داده‌های آرشیوی) در مقیاس بزرگ مناسب است. اگر نیاز به مقیاس‌پذیری نامحدود، هزینه پایین و دسترسی از طریق اینترنت دارید، این روش بهترین انتخاب است. ذخیره‌سازی شیءمحور برای کاربردهایی مانند رایانش ابری، آرشیو داده‌ها و تحلیل داده‌های بزرگ ایده‌آل است.
    4. آیا می‌توان از هر سه روش ذخیره‌سازی در یک سازمان استفاده کرد؟
      بله، بسیاری از سازمان‌های مدرن از یک استراتژی ذخیره‌سازی ترکیبی استفاده می‌کنند. در این مدل، از ذخیره‌سازی سطح بلوک برای برنامه‌های حیاتی، از ذخیره‌سازی سطح فایل برای اشتراک‌گذاری عمومی فایل‌ها و از ذخیره‌سازی شیءمحور برای آرشیو و بکاپ‌های ابری استفاده می‌شود. این رویکرد به سازمان‌ها اجازه می‌دهد تا از مزایای هر سه روش بهره ببرند و یک زیرساخت ذخیره‌سازی بهینه را طراحی کنند.


  • معرفی پروتکل‌های بکاپ و بازیابی داده در سازمان‌ها

    معرفی پروتکل‌های بکاپ و بازیابی داده در سازمان‌ها

    در دنیای دیجیتال امروز، داده‌ها به عنوان یکی از ارزشمندترین دارایی‌های هر سازمان شناخته می‌شوند. از اطلاعات مشتریان و سوابق مالی گرفته تا داده‌های حیاتی عملیاتی، از دست رفتن هر یک از این اطلاعات می‌تواند منجر به فجایع مالی و اعتباری غیرقابل جبران شود. بنابراین، داشتن یک استراتژی جامع و قابل اطمینان برای پشتیبان‌گیری (Backup) و بازیابی داده‌ها (Data Recovery)، یک ضرورت استراتژیک است نه یک انتخاب. در قلب این استراتژی، پروتکل‌های بکاپ قرار دارند. این پروتکل‌ها، قوانین و روش‌هایی هستند که نحوه انتقال، ذخیره‌سازی و مدیریت داده‌ها را در طول فرآیندهای پشتیبان‌گیری و بازیابی تعیین می‌کنند.

    این محتوای جامع، به شما کمک می‌کند تا با انواع مختلف پروتکل‌های بکاپ، ویژگی‌ها، مزایا و معایب آن‌ها آشنا شوید و بهترین راهکار را برای حفاظت از داده‌های ارزشمند سازمان خود انتخاب کنید.

    اهمیت پروتکل‌ها در فرآیند بکاپ و بازیابی

    انتخاب پروتکل مناسب، تأثیر مستقیمی بر سرعت، امنیت، قابلیت اطمینان و کارایی فرآیندهای بکاپ و بازیابی دارد. یک پروتکل ناکارآمد می‌تواند منجر به فرآیندهای طولانی پشتیبان‌گیری، افزایش ریسک از دست رفتن داده‌ها و دشواری در بازیابی آن‌ها شود. در مقابل، یک پروتکل بهینه، تضمین می‌کند که داده‌ها به سرعت و به صورت امن به مقصد منتقل شوند و در زمان نیاز، به آسانی قابل بازیابی باشند.

    پروتکل‌های سطح فایل (File-Level) برای بکاپ

    پروتکل‌های سطح فایل به کاربران امکان می‌دهند تا به صورت فایل و پوشه از داده‌ها پشتیبان‌گیری کنند. این پروتکل‌ها معمولاً برای بکاپ گرفتن از فایل‌های عمومی و اسناد در محیط‌های کاری کوچک و متوسط استفاده می‌شوند.

    1. پروتکل SMB/CIFS

    SMB) Server Message Block) که با نام CIFS) Common Internet File System) نیز شناخته می‌شود، یک پروتکل استاندارد برای اشتراک‌گذاری فایل و منابع در شبکه‌های مایکروسافت ویندوز است. این پروتکل به صورت گسترده برای بکاپ‌گیری در شبکه‌های محلی (LAN) مورد استفاده قرار می‌گیرد.

    نقش SMB در فرآیند بکاپ

    • دسترسی به فایل‌ها: پروتکل SMB به نرم‌افزارهای بکاپ اجازه می‌دهد تا به فایل‌ها و پوشه‌های موجود در سرورها یا کامپیوترهای کلاینت دسترسی پیدا کنند. این دسترسی به صورت مستقیم و بدون نیاز به نصب نرم‌افزار اضافی در سمت کلاینت صورت می‌گیرد.
    • انتقال داده‌ها: پس از دسترسی، داده‌ها از طریق این پروتکل به مقصد بکاپ (مانند یک دستگاه NAS یا سرور پشتیبان) منتقل می‌شوند.

    مزایا و معایب SMB

    SMB یک پروتکل ساده و کاربردی است، اما محدودیت‌هایی نیز دارد.

    • مزایای SMB
      • یکپارچگی با ویندوز: این پروتکل به صورت بومی در سیستم‌عامل‌های ویندوز تعبیه شده است و به سادگی قابل استفاده است، که هزینه‌های راه‌اندازی را کاهش می‌دهد.
      • مدیریت آسان: برای مدیران شبکه‌ای که با محیط ویندوز آشنا هستند، پیکربندی و مدیریت SMB برای بکاپ‌گیری بسیار ساده است.
      • هزینه پایین: نیازی به سخت‌افزار یا نرم‌افزار اضافی ندارد.
    • معایب SMB
      • عملکرد محدود: SMB در شبکه‌های با تأخیر بالا یا پهنای باند کم، عملکرد مطلوبی ندارد و برای بکاپ گرفتن از داده‌های حجیم مناسب نیست.
      • امنیت: نسخه‌های قدیمی SMB (به ویژه SMBv1) دارای آسیب‌پذیری‌های امنیتی هستند که در حملات بزرگی مانند WannaCry مورد سوءاستفاده قرار گرفتند. هرچند نسخه‌های جدیدتر مانند SMBv3 این مشکلات را برطرف کرده‌اند، اما همچنان استفاده از آن در شبکه‌های عمومی توصیه نمی‌شود.

    2. پروتکل NFS) Network File System)

    NFS یک پروتکل اشتراک‌گذاری فایل است که به صورت گسترده در محیط‌های مبتنی بر سیستم‌عامل یونیکس (Unix) و لینوکس (Linux) مورد استفاده قرار می‌گیرد. این پروتکل برای بکاپ‌گیری از سرورهای لینوکس و یونیکس بسیار کارآمد است.

    نقش NFS در فرآیند بکاپ

    • مونت کردن (Mount) منابع: نرم‌افزارهای بکاپ می‌توانند با استفاده از NFS، یک پوشه از سرور پشتیبان را در سرور مبدأ مونت کنند و داده‌ها را به آن منتقل نمایند.
    • انتقال داده‌ها: داده‌ها از طریق پروتکل TCP/IP و با استفاده از NFS به مقصد بکاپ منتقل می‌شوند.

    مزایا و معایب NFS

    NFS یک پروتکل قدرتمند برای محیط‌های لینوکس و یونیکس است.

    • مزایای NFS
      • عملکرد بالا در محیط‌های بومی: NFS به صورت بهینه برای محیط‌های لینوکس طراحی شده است و عملکرد بسیار خوبی را ارائه می‌دهد.
      • انعطاف‌پذیری و پشتیبانی چندپلتفرمی: اگرچه NFS در ابتدا برای یونیکس طراحی شده بود، اما امروزه توسط تمامی سیستم‌عامل‌های اصلی از جمله ویندوز و macOS نیز پشتیبانی می‌شود.
      • پشتیبانی از پروتکل‌های مختلف: نسخه‌های جدید NFS از پروتکل‌های مختلف احراز هویت پشتیبانی می‌کنند که امنیت آن را افزایش می‌دهد.
    • معایب NFS
      • پیچیدگی در محیط‌های ویندوز: پیکربندی NFS در محیط ویندوز ممکن است نسبت به SMB پیچیده‌تر باشد و نیاز به نصب سرویس‌های جانبی دارد.
      • امنیت: نسخه‌های قدیمی NFS دارای ضعف‌های امنیتی هستند که باید با استفاده از روش‌های رمزنگاری و احراز هویت قوی‌تر برطرف شوند.

    پروتکل‌های سطح بلوک (Block-Level) برای بکاپ

    پروتکل‌های سطح بلوک، داده‌ها را به صورت بلوک‌های خام (Raw Blocks) منتقل می‌کنند، نه به صورت فایل و پوشه. این روش برای بکاپ‌گیری از محیط‌های مجازی‌سازی، پایگاه‌های داده و برنامه‌هایی که نیاز به عملکرد بالا دارند، ایده‌آل است.

    3. پروتکل iSCSI

    iSCSI) Internet Small Computer System Interface) یک پروتکل سطح بلوک است که از زیرساخت‌های شبکه استاندارد TCP/IP برای انتقال داده‌ها استفاده می‌کند. این پروتکل به نرم‌افزارهای بکاپ اجازه می‌دهد تا به فضای ذخیره‌سازی از راه دور، درست مانند یک هارد دیسک محلی، دسترسی پیدا کنند.

    نقش iSCSI در فرآیند بکاپ

    • ارائه فضای ذخیره‌سازی مجازی: با استفاده از iSCSI، فضای ذخیره‌سازی از یک دستگاه SAN یا NAS به صورت یک دیسک مجازی به سرور بکاپ معرفی می‌شود.
    • انتقال داده‌ها: داده‌ها به صورت بلوک‌های خام از سرور اصلی به دیسک مجازی منتقل می‌شوند که این امر سرعت بالایی را فراهم می‌کند.

    مزایا و معایب iSCSI

    iSCSI به عنوان یک جایگزین مقرون‌به‌صرفه و انعطاف‌پذیر برای Fibre Channel شناخته می‌شود.

    • مزایای iSCSI
      • هزینه پایین: iSCSI از زیرساخت‌های شبکه اترنت موجود استفاده می‌کند و نیاز به سرمایه‌گذاری در سخت‌افزار گران‌قیمت Fibre Channel را از بین می‌برد.
      • مقیاس‌پذیری آسان: با استفاده از سوییچ‌ها و کابل‌های اترنت، مقیاس‌پذیری iSCSI بسیار ساده و ارزان‌تر است.
      • عملکرد مناسب: با استفاده از تجهیزات مناسب (مانند سوییچ‌های ۱۰ گیگابیت اترنت)، iSCSI می‌تواند عملکرد بسیار خوبی را ارائه دهد.
    • معایب iSCSI
      • عملکرد وابسته به ترافیک شبکه: iSCSI از همان زیرساخت شبکه محلی (LAN) استفاده می‌کند، بنابراین عملکرد آن می‌تواند تحت تأثیر ترافیک LAN قرار گیرد. برای عملکرد بهینه، بهتر است یک شبکه اختصاصی برای آن در نظر گرفته شود.
      • تأخیر بالاتر: iSCCI به دلیل استفاده از TCP/IP، تأخیر بالاتری نسبت به Fibre Channel دارد.

    4. پروتکل Fibre Channel

    Fibre Channel) FC) یک پروتکل اختصاصی و پرسرعت برای شبکه‌های ذخیره‌سازی (SAN) است. این پروتکل از یک شبکه فیزیکی جداگانه و اختصاصی برای انتقال داده‌های سطح بلوک استفاده می‌کند که عملکرد بسیار بالا و تأخیر بسیار پایینی را فراهم می‌کند.

    نقش Fibre Channel در فرآیند بکاپ

    • ارائه فضای ذخیره‌سازی اختصاصی: Fibre Channel به نرم‌افزارهای بکاپ امکان دسترسی به فضای ذخیره‌سازی اختصاصی در یک SAN را می‌دهد.
    • انتقال داده‌ها: داده‌ها با سرعت بسیار بالا و با تأخیر نزدیک به صفر از طریق این شبکه منتقل می‌شوند. این ویژگی برای بکاپ‌گیری از داده‌های حیاتی و حجیم در محیط‌های دیتاسنتر بسیار مهم است.

    مزایا و معایب Fibre Channel

    Fibre Channel به عنوان قدرتمندترین پروتکل برای SAN شناخته می‌شود، اما هزینه و پیچیدگی آن نیز بالاست.

    • مزایای Fibre Channel
      • عملکرد فوق‌العاده: FC بهترین عملکرد ممکن را برای بکاپ‌گیری از برنامه‌هایی مانند پایگاه‌های داده و محیط‌های مجازی‌سازی ارائه می‌دهد.
      • تأخیر بسیار پایین: تأخیر در FC در حد میکروبایت است، که برای بکاپ‌گیری از داده‌های حساس به زمان، حیاتی است.
      • امنیت بالا: از آنجایی که FC یک شبکه کاملاً جداگانه از LAN است، خطر دسترسی غیرمجاز به داده‌های بکاپ به شدت کاهش می‌یابد.
    • معایب Fibre Channel
      • هزینه بسیار بالا: راه‌اندازی یک شبکه FC به دلیل نیاز به سوییچ‌ها، کارت‌های HBA و کابل‌های فیبر نوری گران‌قیمت، بسیار پرهزینه است.
      • پیچیدگی بالا: طراحی، نصب و مدیریت یک شبکه FC نیاز به دانش و تخصص زیادی دارد.

    سایر پروتکل‌ها و تکنولوژی‌های بکاپ

    علاوه بر پروتکل‌های اصلی، تکنولوژی‌ها و پروتکل‌های دیگری نیز در فرآیندهای بکاپ و بازیابی داده‌ها نقش دارند.

    5. پروتکل NDMP) Network Data Management Protocol)

    NDMP یک پروتکل باز برای مدیریت و کنترل انتقال داده‌ها بین دستگاه‌های ذخیره‌سازی متصل به شبکه (NAS) و دستگاه‌های بکاپ (مانند Tape Drives) است. NDMP اجازه می‌دهد تا عملیات بکاپ بدون نیاز به عبور داده‌ها از طریق شبکه LAN و سرور بکاپ انجام شود.

    نقش NDMP در فرآیند بکاپ

    • انتقال مستقیم داده‌ها: NDMP به دستگاه NAS و دستگاه بکاپ (مثلاً یک کتابخانه نواری) اجازه می‌دهد تا به صورت مستقیم با یکدیگر ارتباط برقرار کرده و داده‌ها را بدون دخالت سرور بکاپ منتقل کنند.
    • کاهش بار شبکه: با انتقال داده‌ها به صورت مستقیم، بار ترافیکی از روی شبکه اصلی (LAN) برداشته می‌شود و سرعت فرآیند بکاپ افزایش می‌یابد.

    مزایا و معایب NDMP

    NDMP برای بکاپ‌گیری از دستگاه‌های NAS بسیار کارآمد است.

    • مزایای NDMP
      • عملکرد بالا: با انتقال مستقیم داده‌ها، سرعت بکاپ‌گیری افزایش می‌یابد.
      • کاهش بار سرور: سرور بکاپ از فرآیند انتقال داده‌ها آزاد می‌شود.
    • معایب NDMP
      • وابستگی به سخت‌افزار: هر دو دستگاه NAS و دستگاه بکاپ باید از پروتکل NDMP پشتیبانی کنند.
      • محدودیت کاربرد: این پروتکل فقط برای بکاپ‌گیری از دستگاه‌های NAS مناسب است.

    6. پروتکل RSync

    RSync یک ابزار و پروتکل منبع باز برای همگام‌سازی فایل‌ها و دایرکتوری‌ها بین دو مکان است. RSync به صورت هوشمندانه تنها تغییرات ایجاد شده در فایل‌ها را منتقل می‌کند، که این امر به کاهش حجم داده‌های انتقالی و افزایش سرعت بکاپ‌گیری کمک شایانی می‌کند.

    نقش RSync در فرآیند بکاپ

    • بکاپ افزایشی: RSync تنها داده‌هایی را که از آخرین بکاپ تغییر کرده‌اند، منتقل می‌کند.
    • همگام‌سازی: این پروتکل برای همگام‌سازی فایل‌ها بین سرورهای اصلی و سرورهای پشتیبان به صورت مداوم استفاده می‌شود.

    مزایا و معایب RSync

    RSync یک ابزار بسیار انعطاف‌پذیر و کارآمد است.

    • مزایای RSync
      • صرفه‌جویی در پهنای باند: با انتقال تنها تغییرات، پهنای باند مصرفی به شدت کاهش می‌یابد.
      • انعطاف‌پذیری بالا: RSync در محیط‌های مختلف قابل استفاده است.
    • معایب RSync
      • فقدان مدیریت مرکزی: RSync ابزاری ساده است و فاقد قابلیت‌های مدیریت و نظارت پیشرفته است.

    انتخاب پروتکل مناسب برای استراتژی بکاپ شما

    انتخاب پروتکل بکاپ مناسب، یک تصمیم استراتژیک است که به نیازهای خاص سازمان شما بستگی دارد. در اینجا به برخی از سناریوهای رایج اشاره می‌کنیم.

    سناریوی 1: بکاپ از فایل‌های عمومی در یک دفتر کار کوچک

    • نیاز: بکاپ‌گیری از اسناد و فایل‌های کاری روزمره کاربران در یک شبکه محلی.
    • راهکار: استفاده از پروتکل SMB برای بکاپ‌گیری از کامپیوترهای ویندوز به یک دستگاه NAS. این راهکار ساده، ارزان و برای این محیط کاملاً مناسب است.

    سناریوی 2: بکاپ از محیط مجازی‌سازی در یک دیتاسنتر

    • نیاز: بکاپ‌گیری از ماشین‌های مجازی که بر روی یک شبکه SAN اجرا می‌شوند.
    • راهکار: استفاده از پروتکل iSCSI یا Fibre Channel. این پروتکل‌ها به نرم‌افزار بکاپ امکان دسترسی سریع و سطح بلوک را به داده‌ها می‌دهند، که برای بکاپ از دیتاسنترها و محیط‌های مجازی‌سازی حیاتی است.

    سناریوی 3: بکاپ از سرورهای لینوکس

    • نیاز: بکاپ‌گیری از چندین سرور لینوکس در یک سازمان.
    • راهکار: استفاده از پروتکل NFS. این پروتکل به صورت بومی در لینوکس عملکرد خوبی دارد و برای مدیریت داده‌های بکاپ سرورهای لینوکس ایده‌آل است.

    پروتکل‌های پشتیبان‌گیری ابری و تکنولوژی‌های نوین

    با گسترش استفاده از سرویس‌های ابری، پروتکل‌ها و تکنولوژی‌های جدیدی برای پشتیبان‌گیری از داده‌ها در محیط‌های ابری نیز ظهور کرده‌اند.

    7. پروتکل S3) Simple Storage Service)

    S3 یک پروتکل ذخیره‌سازی شیءمحور (Object Storage) است که توسط شرکت آمازون توسعه داده شده است. S3 به دلیل مقیاس‌پذیری نامحدود و هزینه پایین، به یک استاندارد صنعتی برای پشتیبان‌گیری ابری تبدیل شده است.

    نقش S3 در فرآیند بکاپ

    • ذخیره‌سازی داده‌های حجیم: S3 برای ذخیره حجم عظیمی از داده‌های بکاپ، مانند فایل‌های پشتیبان کامل سیستم‌ها، بسیار مناسب است.
    • انتقال از طریق HTTPS: انتقال داده‌ها از طریق پروتکل امن HTTPS صورت می‌گیرد.

    مزایا و معایب S3

    • مزایای S3
      • مقیاس‌پذیری نامحدود: می‌توانید به راحتی ظرفیت ذخیره‌سازی را بدون نگرانی از محدودیت‌های فیزیکی افزایش دهید.
      • هزینه پایین: مدل پرداخت در S3 بر اساس میزان استفاده است که آن را بسیار مقرون‌به‌صرفه می‌کند.
    • معایب S3
      • تأخیر بالا: به دلیل ماهیت اینترنت، دسترسی به داده‌ها در S3 ممکن است با تأخیر همراه باشد.

    8. تکنولوژی VSS) Volume Shadow Copy Service)

    VSS یک سرویس مایکروسافت ویندوز است که به برنامه‌های بکاپ اجازه می‌دهد تا از داده‌ها در زمانی که در حال استفاده هستند، پشتیبان‌گیری کنند. این سرویس با ایجاد یک “عکس فوری” (Snapshot) از داده‌ها، تضمین می‌کند که فایل‌های در حال تغییر نیز به صورت کامل و بدون خطا پشتیبان‌گیری شوند.

    نقش VSS در فرآیند بکاپ

    • بکاپ بدون وقفه: VSS به نرم‌افزارهای بکاپ امکان می‌دهد که از فایل‌های باز و در حال استفاده، مانند فایل‌های پایگاه داده، پشتیبان‌گیری کنند.
    • همگام‌سازی داده‌ها: با ایجاد یک Snapshot از داده‌ها، VSS تضمین می‌کند که تمامی اطلاعات در یک لحظه مشخص و به صورت همگام پشتیبان‌گیری شوند.

    مزایا و معایب VSS

    • مزایای VSS
      • دقت و همگام‌سازی: این سرویس تضمین می‌کند که بکاپ‌ها دقیق و قابل اعتماد باشند.
      • یکپارچگی با سیستم‌عامل: VSS به صورت بومی در ویندوز تعبیه شده است و به سادگی قابل استفاده است.
    • معایب VSS
      • وابستگی به سیستم‌عامل: VSS یک سرویس ویندوزی است و برای سیستم‌عامل‌های دیگر در دسترس نیست.
      • پیچیدگی فنی: در برخی موارد، پیکربندی VSS ممکن است پیچیده باشد.

    نتیجه‌گیری

    پشتیبان‌گیری و بازیابی داده‌ها، فرآیندهایی حیاتی برای هر سازمانی هستند. انتخاب پروتکل‌های بکاپ مناسب، نقش کلیدی در تضمین موفقیت این فرآیندها دارد. از پروتکل‌های ساده مانند SMB و NFS برای بکاپ‌گیری از فایل‌های عمومی، تا پروتکل‌های قدرتمند مانند iSCSI و Fibre Channel برای محیط‌های دیتاسنتر، هر پروتکل کاربرد و مزایای خاص خود را دارد. با درک دقیق این پروتکل‌ها، می‌توانید یک استراتژی بکاپ و بازیابی قوی، ایمن و کارآمد برای حفاظت از ارزشمندترین دارایی‌های سازمان خود طراحی کنید.

    سوالات متداول 

    1. بهترین پروتکل برای بکاپ گرفتن از محیط‌های مجازی‌سازی (مانند VMware) چیست؟
      بهترین پروتکل‌ها برای بکاپ گرفتن از محیط‌های مجازی‌سازی، پروتکل‌های سطح بلوک مانند iSCSI و Fibre Channel هستند. این پروتکل‌ها به نرم‌افزارهای بکاپ اجازه می‌دهند که به صورت مستقیم و با سرعت بالا به داده‌های ماشین‌های مجازی دسترسی پیدا کنند. استفاده از این پروتکل‌ها به دلیل تأخیر پایین، فرآیندهای بکاپ و بازیابی را بسیار سریع‌تر می‌کند.
    2. آیا می‌توانم برای بکاپ گرفتن از داده‌ها از SMB و NFS به صورت همزمان استفاده کنم؟
      بله، استفاده همزمان از SMB و NFS یک رویکرد رایج در محیط‌های ترکیبی (Heterogeneous) است که از هر دو سیستم‌عامل ویندوز و لینوکس استفاده می‌کنند. برای مثال، می‌توانید از SMB برای بکاپ گرفتن از فایل‌های کاربران ویندوزی و از NFS برای بکاپ گرفتن از سرورهای لینوکس استفاده کنید. نرم‌افزارهای بکاپ مدرن به راحتی از هر دو پروتکل پشتیبانی می‌کنند و این امر مدیریت را ساده می‌سازد.
    3. پشتیبان‌گیری از داده‌ها به صورت ابری چه مزایایی دارد و چه پروتکلی برای آن استفاده می‌شود؟
      پشتیبان‌گیری ابری مزایایی مانند مقیاس‌پذیری نامحدود، هزینه پایین و در دسترس بودن بالا را فراهم می‌کند. در این روش، داده‌ها به جای ذخیره‌سازی در مکان محلی، به سرورهای ارائه‌دهنده خدمات ابری منتقل می‌شوند. پروتکل اصلی برای پشتیبان‌گیری ابری، S3 است که به دلیل انعطاف‌پذیری و هزینه مقرون‌به‌صرفه، به استاندارد صنعتی تبدیل شده است.
    4. چگونه می‌توانم مطمئن شوم که پروتکل انتخابی من از امنیت کافی برخوردار است؟
      برای تضمین امنیت، ابتدا باید از آخرین نسخه‌های پروتکل‌ها (مانند SMBv3) استفاده کنید که قابلیت‌های رمزنگاری و احراز هویت قوی‌تری دارند. همچنین، استفاده از شبکه‌های جداگانه برای انتقال داده‌های بکاپ (مانند SAN) می‌تواند امنیت را افزایش دهد. در نهایت، پیاده‌سازی مکانیزم‌های احراز هویت مانند CHAP در iSCSI و استفاده از پروتکل‌های رمزنگاری مانند HTTPS در پروتکل S3، امنیت داده‌ها را در حین انتقال تضمین می‌کند.


  • هنگ کردن EMC SAN Storage: دلایل، پیشگیری و راهکارهای رفع مشکل

    هنگ کردن EMC SAN Storage: دلایل، پیشگیری و راهکارهای رفع مشکل

    EMC SAN Storage یکی از پیشرفته‌ترین راهکارهای ذخیره‌سازی در سطح سازمانی است که به دلیل قابلیت‌های بالا، در بسیاری از محیط‌های IT استفاده می‌شود. با این حال، مانند هر سیستم پیچیده‌ای، ممکن است در برخی شرایط با مشکلاتی مانند هنگ کردن یا از کار افتادن مواجه شود. این مقاله به طور جامع به بررسی علل هنگ کردن EMC SAN Storage، روش‌های پیشگیری، و راهکارهای رفع این مشکل پرداخته است.

     EMC SAN Storage چیست؟

    EMC SAN Storage یکی از محصولات شرکت Dell EMC است که برای ذخیره‌سازی داده‌ها در محیط‌های بزرگ سازمانی طراحی شده است. این سیستم‌ها از فناوری‌های پیشرفته‌ای مانند RAID، Thin Provisioning، و Deduplication بهره می‌برند تا امنیت، کارایی، و انعطاف‌پذیری بالایی ارائه دهند.

    دلایل هنگ کردن EMC SAN Storage

    هنگ کردن (Hang) یا متوقف شدن عملکرد EMC SAN Storage ممکن است ناشی از عوامل مختلفی باشد که به سخت‌افزار، نرم‌افزار، یا تنظیمات سیستم مرتبط است. در ادامه به دلایل اصلی این مشکل پرداخته‌ایم:

    1. مشکلات سخت‌افزاری

    • خرابی دیسک‌ها (Hard Drive Failure):
      نقص یا خرابی در دیسک‌ها یکی از دلایل اصلی هنگ کردن است که می‌تواند باعث از دست رفتن داده‌ها یا کندی سیستم شود.

    • مشکلات کنترلرها (Controller Issues):
      خرابی یا عدم تطابق در عملکرد کنترلرهای SAN می‌تواند باعث عدم پاسخگویی سیستم شود.

    • منابع تغذیه (Power Supply Issues):
      نوسانات برق یا خرابی واحدهای تغذیه ممکن است منجر به خاموشی ناگهانی یا توقف عملکرد سیستم شود.

    • مشکلات خنک‌کننده:
      افزایش دما در اثر نقص سیستم خنک‌کننده می‌تواند به آسیب سخت‌افزاری و توقف عملکرد منجر شود.

    2. نقص در Firmware یا سیستم‌عامل

    • نسخه‌های قدیمی Firmware:
      استفاده از نسخه‌های قدیمی Firmware ممکن است حاوی باگ‌هایی باشد که باعث ایجاد اختلال در عملکرد سیستم شود.

    • عدم تطابق سیستم‌عامل:
      ناسازگاری بین سیستم‌عامل سرورها و SAN Storage می‌تواند باعث بروز مشکلات ارتباطی شود.

    • بروز نبودن نرم‌افزار مدیریت:
      ابزارهای مدیریتی قدیمی ممکن است در شناسایی مشکلات یا مدیریت منابع ضعیف عمل کنند.

    3. ترافیک بیش از حد یا بار سنگین

    • Overloading I/O:
      حجم زیاد درخواست‌های ورودی/خروجی (I/O) می‌تواند باعث کندی یا توقف موقت SAN شود.

    • مشکلات شبکه:
      ترافیک سنگین در مسیرهای ارتباطی یا نقص در سوئیچ‌ها و کابل‌های شبکه ممکن است ارتباط میان سرورها و SAN را مختل کند.

    • عدم توزیع مناسب بار:
      عدم استفاده از قابلیت Load Balancing باعث تمرکز بار بر یک کنترلر شده و در نتیجه موجب هنگ کردن می‌شود.

    4. اشتباهات در پیکربندی

    • پیکربندی نادرست RAID:
      تنظیمات اشتباه در سطح RAID ممکن است باعث بروز مشکلاتی مانند عدم همگام‌سازی یا کندی عملکرد شود.

    • خطا در Zoning یا LUN Masking:
      تنظیمات اشتباه در Zoning یا LUN Masking ممکن است باعث از دست رفتن دسترسی سرورها به ذخیره‌سازی شود.

    • Multipathing نادرست:
      خطا در مسیرهای چندگانه (Multipath) می‌تواند منجر به قطع ارتباط یا کندی شود.

    5. مشکلات نرم‌افزاری و خطاهای برنامه‌ها

    • Crash کردن برنامه‌های مدیریتی:
      ابزارهایی مانند EMC Unisphere ممکن است در اثر مشکلات نرم‌افزاری پاسخگو نباشند.

    • نقص در Hypervisor:
      در محیط‌های مجازی‌سازی، مشکلات Hypervisor مانند VMware ESXi می‌تواند ارتباط با SAN را مختل کند.

    6. فرسودگی و عمر بالای سیستم

    • استفاده طولانی‌مدت از قطعات:
      سیستم‌هایی که مدت طولانی در حال کار هستند ممکن است به دلیل فرسودگی قطعات دچار مشکلات مکرر شوند.

    • پایین آمدن عملکرد دیسک‌ها:
      کاهش کارایی دیسک‌ها به دلیل استفاده مستمر، می‌تواند به کندی و در نهایت هنگ کردن سیستم منجر شود.

    7. عدم مانیتورینگ و نگهداری منظم

    • عدم شناسایی مشکلات زودهنگام:
      نبود مانیتورینگ مداوم باعث می‌شود مشکلات کوچک به بحران‌های بزرگ تبدیل شوند.

    • تعمیر و نگهداری نامنظم:
      عدم انجام سرویس‌های دوره‌ای می‌تواند به تجمع مشکلات و خرابی‌های ناگهانی منجر شود.

    راهکارهای پیشگیری از هنگ کردن EMC SAN Storage

    1. مانیتورینگ مداوم

    • استفاده از ابزارهایی مانند EMC Unisphere برای نظارت بر عملکرد SAN.
    • شناسایی مشکلات پیش از وقوع خرابی.

    2. به‌روزرسانی منظم

    • به‌روزرسانی Firmware و سیستم‌عامل به نسخه‌های پایدار و جدید.

    3. بهینه‌سازی ترافیک شبکه

    • استفاده از سوئیچ‌های پرسرعت و تنظیمات مناسب QoS.
    • بررسی و تنظیم مجدد مسیرهای شبکه (Path Management).

    4. تست منظم سخت‌افزار

    • اجرای تست‌های دوره‌ای برای شناسایی قطعات معیوب.
    • جایگزینی قطعات پیش از خرابی کامل.

    مراحل عیب‌یابی هنگ کردن SAN Storage

    گام 1: بررسی وضعیت سخت‌افزار

    • چک کردن سلامت دیسک‌ها، کنترلرها، و منابع تغذیه.
    • اطمینان از عدم وجود اشکال در سیستم خنک‌کننده.

    گام 2: بررسی رویدادها (Logs)

    • مرور لاگ‌های سیستم با استفاده از EMC Unisphere یا CLI.
    • شناسایی خطاها و هشدارهای خاص.

    گام 3: تحلیل ترافیک شبکه

    • استفاده از ابزارهای مانیتورینگ شبکه برای شناسایی گلوگاه‌ها.
    • بررسی وضعیت مسیرهای چندگانه (Multipath).

    گام 4: تست تنظیمات

    • بررسی صحت تنظیمات RAID، LUN Masking، و Zoning.
    • اطمینان از پیکربندی صحیح ماشین‌های مجازی و سرورها.

    نحوه رفع مشکل هنگ کردن EMC SAN Storage

    1. راه‌اندازی مجدد کنترلرها
    • اگر سیستم به کنترلرها پاسخ نمی‌دهد، ریست کنترلرها می‌تواند مشکل را موقتاً رفع کند.
    1. به‌روزرسانی Firmware
    • نصب آخرین نسخه Firmware برای برطرف کردن مشکلات نرم‌افزاری.
    1. تعویض قطعات معیوب
    • جایگزینی دیسک‌ها، منابع تغذیه یا کنترلرهای خراب.
    1. بازتنظیم ترافیک
    • تغییر تنظیمات مسیرهای چندگانه (Multipathing) برای بهینه‌سازی توزیع بار.
    1. بازسازی تنظیمات
    • در صورت بروز مشکل در تنظیمات، بازنشانی و پیکربندی مجدد سیستم ذخیره‌سازی ممکن است نیاز باشد.

    نکات نگهداری و بهینه‌سازی EMC SAN Storage

    • اجرای برنامه‌های پشتیبان‌گیری منظم برای جلوگیری از از دست دادن داده‌ها.
    • مانیتورینگ عملکرد سیستم با استفاده از نرم‌افزارهای مدیریتی EMC.
    • آموزش کارکنان IT برای مدیریت بهینه SAN Storage.
    • استفاده از قطعات اصلی و مجاز برای جلوگیری از خرابی‌های غیرمنتظره.

     نتیجه‌گیری

    هنگ کردن EMC SAN Storage مشکلی است که می‌تواند عملکرد سازمان را تحت تأثیر قرار دهد، اما با شناخت علل، پیشگیری‌های مناسب، و به‌کارگیری راهکارهای مؤثر، می‌توان از بروز این مشکل جلوگیری کرد. استفاده از ابزارهای مانیتورینگ و به‌روزرسانی مداوم سیستم، کلید اصلی برای حفظ پایداری و عملکرد بهینه SAN Storage است.

     پرسش‌های متداول

    1. هنگ کردن SAN Storage چه زمانی رخ می‌دهد؟
      هنگ کردن معمولاً در اثر بار بیش از حد، خرابی سخت‌افزار یا مشکلات پیکربندی رخ می‌دهد.
    2. آیا تعویض دیسک معیوب مشکل را حل می‌کند؟
      در صورت خرابی دیسک، تعویض آن می‌تواند به رفع مشکل کمک کند، اما دلایل دیگر باید بررسی شوند.
    3. چگونه می‌توان از هنگ کردن SAN پیشگیری کرد؟
      با به‌روزرسانی منظم، مانیتورینگ مداوم، و بهینه‌سازی تنظیمات می‌توان از این مشکل جلوگیری کرد.
    4. آیا مشکلات نرم‌افزاری باعث هنگ کردن می‌شود؟
      بله، باگ‌های نرم‌افزاری یا عدم به‌روزرسانی سیستم‌عامل می‌توانند باعث هنگ کردن شوند.
    5. ابزار مناسب برای مدیریت EMC SAN چیست؟
      EMC Unisphere و CLI ابزارهای اصلی برای مدیریت و عیب‌یابی EMC SAN Storage هستند.


  • همه‌چیز درباره iSCSI؛ پروتکل ذخیره‌سازی مقرون‌به‌صرفه و کاربردی برای شبکه‌های مدرن

    همه‌چیز درباره iSCSI؛ پروتکل ذخیره‌سازی مقرون‌به‌صرفه و کاربردی برای شبکه‌های مدرن

    با رشد نیازهای ذخیره‌سازی و دسترسی سریع به داده‌ها، سازمان‌ها به راهکارهایی مانند iSCSI روی آورده‌اند. iSCSI یک پروتکل ذخیره‌سازی مبتنی بر IP است که با استفاده از شبکه‌های TCP/IP امکان انتقال داده‌ها را با هزینه‌ای مناسب فراهم می‌کند. این فناوری به سرورها اجازه می‌دهد که با دستگاه‌های ذخیره‌سازی ارتباط برقرار کنند و فضای ذخیره‌سازی خود را افزایش دهند. در این مقاله، به بررسی مفهوم iSCSI، نحوه عملکرد، اجزای کلیدی، مزایا، چالش‌ها و امنیت این پروتکل می‌پردازیم.

    آی اسکازی (iSCSI) چیست؟

    آی اسکازی (iSCSI) یک پروتکل ذخیره‌سازی مبتنی بر IP است که برای انتقال داده‌ها از طریق شبکه‌های TCP/IP مورد استفاده قرار می‌گیرد. این پروتکل به سرورها و دستگاه‌های ذخیره‌سازی امکان می‌دهد به‌صورت مجازی به درایوهای ذخیره‌سازی در شبکه دسترسی داشته باشند، گویی که مستقیماً به آن‌ها متصل هستند. به دلیل هزینه کمتر و کارایی مناسب، iSCSI به یک راهکار محبوب در شبکه‌های ذخیره‌سازی کوچک و متوسط تبدیل شده است.

    iSCSI چگونه کار می‌کند؟

    iSCSI از بسته‌های IP برای انتقال داده‌ها بین دستگاه‌ها استفاده می‌کند. این فرآیند از طریق دو جزء اصلی انجام می‌شود: initiator (آغازگر) که از سمت سرور داده‌ها را ارسال می‌کند و target (هدف) که دستگاه ذخیره‌سازی دریافت‌کننده داده است. داده‌ها به بلاک‌های کوچکی تقسیم و به صورت بسته‌های IP ارسال می‌شوند. این مدل انتقال از راه دور و بر روی شبکه‌های TCP/IP به صورت بهینه انجام می‌شود و امکان ارتباط سریع و امن با دستگاه‌های ذخیره‌سازی را فراهم می‌کند.

    نحوه پیاده‌سازی iSCSI Storage چگونه است؟

    برای پیاده‌سازی iSCSI ابتدا باید initiator و target را پیکربندی کنید. ابتدا initiator (که معمولاً یک سرور یا دستگاه کلاینت است) را با هدف برقراری ارتباط با target پیکربندی کنید. سپس آدرس IP، پورت و اطلاعات احراز هویت target در سیستم initiator تنظیم می‌شود. در نهایت، ارتباط میان initiator و target برقرار شده و فضای ذخیره‌سازی قابل دسترسی است. iSCSI معمولاً در شبکه‌های محلی (LAN) و با استفاده از دستگاه‌های اترنت پیکربندی می‌شود.

    استفاده از iSCSI چه مزایایی دارد؟

    • هزینه کمتر: نیاز به تجهیزات خاصی مانند فیبر نوری ندارد و با زیرساخت‌های شبکه‌ای معمولی سازگار است.
    • قابلیت مقیاس‌پذیری: به راحتی می‌توان فضای ذخیره‌سازی بیشتری به سیستم اضافه کرد.
    • سهولت در پیاده‌سازی: نسبت به سایر روش‌ها، نصب و راه‌اندازی iSCSI ساده‌تر است.
    • انعطاف‌پذیری: به دلیل استفاده از پروتکل IP، iSCSI در شبکه‌های مختلف و با سیستم‌عامل‌های متنوع سازگار است.

    اجزای اصلی iSCSI

    اجزای اصلی آی اسکازی از قرار زیر است:

    iSCSI Initiator

    Initiator بخشی از سیستم است که درخواست‌های داده را آغاز می‌کند و ارتباط با دستگاه ذخیره‌سازی را از طریق پروتکل iSCSI برقرار می‌سازد. این قسمت معمولاً در سمت سرور یا کلاینتی قرار دارد که به داده‌ها نیاز دارد.

    iSCSI Target

    Target دستگاهی است که داده‌ها را از initiator دریافت کرده و آن‌ها را ذخیره می‌کند. این بخش معمولاً شامل دستگاه‌های ذخیره‌سازی مانند هارد دیسک‌ها و سیستم‌های ذخیره‌سازی SAN است.

    آی اسکازی چه محدودیت‌هایی دارد؟

    • وابستگی به شبکه اترنت: کارایی iSCSI به پهنای باند شبکه بستگی دارد و در صورت شلوغی شبکه ممکن است دچار افت سرعت شود.
    • نیاز به تنظیمات پیشرفته امنیتی: برای جلوگیری از دسترسی غیرمجاز، تنظیمات امنیتی پیچیده‌تری لازم است.
    • مصرف زیاد CPU: پردازش داده‌ها و انتقال بسته‌های IP می‌تواند بار زیادی بر روی CPU وارد کند.

    جایگزین‌های اترنت برای iSCSI

    در برخی از شبکه‌ها، برای افزایش کارایی و سرعت، از جایگزین‌هایی مانند فیبر نوری به‌جای اترنت استفاده می‌شود. همچنین، پروتکل‌های دیگری مانند FC (Fibre Channel) و FCoE (Fibre Channel over Ethernet) در محیط‌های ذخیره‌سازی استفاده می‌شوند که سرعت بالاتری نسبت به iSCSI ارائه می‌دهند.

    بررسی امنیت iSCSI

    برای اطمینان از امنیت ارتباط iSCSI، از مکانیزم‌هایی مانند احراز هویت CHAP (Challenge Handshake Authentication Protocol)، رمزنگاری داده‌ها، و کنترل دسترسی IP استفاده می‌شود. استفاده از این پروتکل‌های امنیتی می‌تواند از دسترسی غیرمجاز و حملات نفوذی جلوگیری کرده و امنیت داده‌ها را در شبکه‌های ذخیره‌سازی بهبود بخشد. 

    جمع‌بندی:

    iSCSI به دلیل هزینه کمتر، سهولت در پیاده‌سازی و قابلیت انعطاف‌پذیری در مدیریت داده‌ها، راه‌حلی کارآمد برای ذخیره‌سازی در سازمان‌هاست. این پروتکل، علیرغم برخی محدودیت‌ها مانند وابستگی به شبکه و نیاز به امنیت بالا، گزینه‌ای مناسب برای دسترسی سریع به داده‌ها از طریق شبکه است. با پیاده‌سازی و تنظیمات امنیتی مناسب، iSCSI می‌تواند گزینه‌ای پایدار و امن برای افزایش فضای ذخیره‌سازی و بهینه‌سازی دسترسی به داده‌ها باشد.

    سوالات متداول:

    • iSCSI چیست؟

    iSCSI یک پروتکل ذخیره‌سازی مبتنی بر IP است که برای انتقال داده‌ها از طریق شبکه‌های TCP/IP استفاده می‌شود و امکان اتصال سرورها به دستگاه‌های ذخیره‌سازی را فراهم می‌کند.

    • آیا استفاده از iSCSI امنیت دارد؟

    بله، iSCSI می‌تواند با تنظیم احراز هویت CHAP، رمزنگاری و کنترل دسترسی امن شود؛ اما نیاز به تنظیمات امنیتی دقیق دارد.

    • چگونه می‌توان کارایی iSCSI را بهبود داد؟  

    برای بهبود کارایی iSCSI می‌توان از شبکه‌های پرسرعت، سوئیچ‌های مخصوص ذخیره‌سازی و تنظیمات بهینه روی سرورها استفاده کرد.


  •  شبکه SAN چیست؟ راهکاری قدرتمند برای ذخیره‌سازی سریع و مطمئن داده‌ها

     شبکه SAN چیست؟ راهکاری قدرتمند برای ذخیره‌سازی سریع و مطمئن داده‌ها

    در دنیای امروز که حجم اطلاعات به شکل چشمگیری افزایش یافته است، روش‌های سنتی ذخیره‌سازی پاسخگوی نیازهای سازمان‌ها و مراکز داده بزرگ نیستند. شبکه‌های ذخیره‌سازی SAN (Storage Area Network) راهکاری پیشرفته و تخصصی برای ذخیره و مدیریت حجم عظیمی از داده‌ها هستند. این نوع شبکه‌ها به دلیل سرعت بالا، پایداری و قابلیت ارتقاء خود، به یکی از راه‌حل‌های محبوب برای ذخیره‌سازی داده‌ها تبدیل شده‌اند. در این مقاله، به معرفی شبکه SAN، نحوه عملکرد آن، کاربردها، مزایا و معایب، پروتکل‌های مختلف، و انواع رویکردهای موجود در این شبکه می‌پردازیم.

    شبکه SAN یا Storage Area Network چیست؟

    شبکه ذخیره‌سازی SAN یک نوع شبکه تخصصی است که برای ذخیره و دسترسی به داده‌های حجیم در سازمان‌ها و مراکز داده استفاده می‌شود. این نوع شبکه به سیستم‌ها اجازه می‌دهد تا به منابع ذخیره‌سازی به صورت مستقیم و با سرعت بالا دسترسی داشته باشند. SAN با فراهم کردن یک ساختار شبکه‌ای جداگانه برای دسترسی به ذخیره‌سازها، باعث کاهش بار روی شبکه اصلی می‌شود و به سرورها این امکان را می‌دهد که به شکل مستقیم و بدون نیاز به شبکه محلی (LAN)، با منابع ذخیره‌سازی ارتباط برقرار کنند.

    نحوه عملکرد شبکه SAN چگونه است؟

    شبکه SAN به گونه‌ای طراحی شده است که داده‌ها را بین منابع ذخیره‌سازی و سرورها با کمترین تأخیر انتقال دهد. این عملکرد از طریق سه لایه اصلی انجام می‌شود: لایه هاست، لایه فابریک و لایه ذخیره ساز.

    لایه هاست

    لایه هاست شامل سرورهایی است که به شبکه SAN متصل می‌شوند و از داده‌های ذخیره شده در SAN استفاده می‌کنند. سرورها با استفاده از رابط‌های مشخص مانند FC HBA (Fiber Channel Host Bus Adapter) به SAN متصل می‌شوند.

    لایه فابریک

    لایه فابریک نقش مهمی در برقراری ارتباط بین هاست‌ها و ذخیره‌سازها دارد. این لایه شامل سوئیچ‌ها و روترها است و وظیفه انتقال داده‌ها را با سرعت و پایداری بالا بین لایه هاست و ذخیره ساز بر عهده دارد. فناوری‌های مورد استفاده در این لایه معمولا شامل Fiber Channel و Ethernet هستند.

    لایه ذخیره ساز

    لایه ذخیره ساز، جایی است که داده‌ها در آن ذخیره می‌شوند. این لایه شامل دستگاه‌های ذخیره‌سازی مانند دیسک‌های سخت و تجهیزات ذخیره‌سازی مبتنی بر فلش است که قابلیت ذخیره حجم بالایی از داده‌ها را دارند.

    نحوه راه اندازی شبکه فضای ذخیره سازی (SAN)

    برای راه اندازی یک شبکه SAN مراحل زیر را باید انجام دهید:

    1. برنامه‌ریزی و طراحی شبکه: ابتدا نیازهای شبکه ذخیره‌سازی را بررسی کرده و معماری مناسب برای آن طراحی کنید.
    2. انتخاب تجهیزات: سوئیچ‌ها، هاب‌ها، رابط‌های HBA، و ذخیره‌سازها بر اساس نیاز انتخاب و خریداری شوند.
    3. نصب و تنظیم تجهیزات: تجهیزات به سرور و ذخیره‌ساز متصل شده و تنظیمات اولیه برای برقراری ارتباط انجام شود.

    4.پیکربندی پروتکل‌ها: پروتکل‌هایی مانند FCP یا iSCSI پیکربندی شده و برای انتقال داده‌ها آماده‌سازی شود.

    کاربردهای شبکه SAN

    شبکه‌های SAN در محیط‌های مختلفی استفاده می‌شوند، از جمله:

    • مراکز داده: برای مدیریت و انتقال حجم بالای داده.
    • سازمان‌ها: برای ذخیره‌سازی پایگاه‌های داده.
    • صنایع مالی و بانکی: برای حفظ داده‌ها و پشتیبان‌گیری.
    • مراکز آموزشی و تحقیقاتی: برای نگهداری اطلاعات تحقیقاتی و آرشیو داده‌ها.

    مزایا و معایب استفاده از شبکه SAN

    استفاده از SAN مزایا و معایب خاص خود را دارد:


    مزایا

    • سرعت بالا: انتقال داده‌ها با سرعت بالا بین سرورها و ذخیره‌سازها.
    • کاهش بار شبکه اصلی: انتقال داده‌ها از شبکه اصلی به شبکه SAN.
    • قابلیت ارتقاء: افزایش ظرفیت ذخیره‌سازی با افزودن دستگاه‌های جدید.

    معایب

    • هزینه بالا: نیاز به تجهیزات گران قیمت.
    • پیچیدگی در مدیریت: نیاز به تخصص برای راه‌اندازی و پیکربندی.

    پروتکل‌های شبکه ذخیره‌سازی SAN

    شبکه‌های SAN از پروتکل‌های متنوعی برای انتقال داده استفاده می‌کنند:

    FCP (Fiber Channel Protocol)

    پروتکل اصلی در شبکه‌های SAN مبتنی بر فیبر که انتقال داده‌ها با سرعت و پایداری بالا را فراهم می‌کند.

    iSCSI (Internet Small Computer System Interface)

    این پروتکل از شبکه TCP/IP برای انتقال داده‌ها استفاده کرده و نسبت به FCP هزینه کمتری دارد، ولی برای محیط‌های بزرگ پیشنهاد نمی‌شود.

    FCoE (Fiber Channel over Ethernet)

    ترکیبی از فناوری Fiber Channel و Ethernet، این پروتکل به سیستم‌ها اجازه می‌دهد داده‌ها را از طریق شبکه Ethernet منتقل کنند.

     انواع رویکردهای SAN

    شبکه‌های SAN رویکردهای مختلفی برای پیاده‌سازی دارند:

    SAN مجازی

    یک SAN نرم‌افزاری که منابع ذخیره‌سازی را از طریق شبکه‌های مجازی به سیستم‌ها ارائه می‌دهد.

     یکپارچه

    در این روش، شبکه SAN با سایر شبکه‌های موجود در سازمان یکپارچه می‌شود و امکان مدیریت متمرکز فراهم می‌شود.

    SAN همگرا

    این نوع SAN با دیگر شبکه‌ها و زیرساخت‌های فناوری اطلاعات به صورت همگرا ترکیب شده و قابلیت‌های مدیریت و مقیاس‌پذیری بالاتری را فراهم می‌کند.

    بررسی استانداردهای فناوری SAN

    استانداردهای مختلفی برای SAN وجود دارد که شامل استانداردهای فیبر نوری، پروتکل‌های شبکه و ابزارهای مدیریت و پشتیبانی است. این استانداردها موجب سازگاری و یکپارچگی در تجهیزات مختلف شبکه‌های SAN می‌شوند.

    چه تفاوتی میان NAS و SAN وجود دارد؟

    شبکه‌های SAN و NAS هر دو برای ذخیره‌سازی داده‌ها استفاده می‌شوند، اما تفاوت‌های مهمی بین آنها وجود دارد. در حالی که SAN برای انتقال داده‌های حجیم و با سرعت بالا به کار می‌رود، NAS بیشتر برای ذخیره‌سازی فایل‌ها و دسترسی به آنها از طریق شبکه محلی (LAN) استفاده می‌شود.

    جمع‌بندی:

    شبکه SAN با ساختار خاص و انعطاف‌پذیر خود، راهکاری ایده‌آل برای سازمان‌ها و مراکز داده‌ای است که نیاز به ذخیره‌سازی و انتقال داده‌های حجیم با سرعت بالا دارند. با اینکه پیاده‌سازی این شبکه‌ها هزینه و پیچیدگی‌های خاص خود را دارد، اما مزایای آن مانند افزایش سرعت و کاهش بار شبکه محلی، برای بسیاری از سازمان‌ها غیرقابل چشم‌پوشی است. با توجه به پیشرفت تکنولوژی و ظهور استانداردها و پروتکل‌های جدید، SAN همچنان در حال توسعه و بهبود بوده و آینده روشنی در حوزه ذخیره‌سازی داده‌ها دارد.

    سوالات متداول:

    • شبکه ذخیره‌سازی SAN چیست؟  

    SAN یک شبکه تخصصی ذخیره‌سازی است که به سرورها امکان می‌دهد به داده‌ها به‌صورت سریع و مستقیم دسترسی داشته باشند و معمولاً در مراکز داده بزرگ استفاده می‌شود.

    • SAN چه تفاوتی با NAS دارد؟ 

    SAN مبتنی بر بلاک است و به دسترسی سریع داده‌ها کمک می‌کند، در حالی که NAS مبتنی بر فایل است و برای اشتراک‌گذاری فایل‌ها از طریق شبکه محلی مناسب‌تر است.

    • اجزای اصلی یک SAN کدامند؟ 

    اجزای اصلی SAN شامل سرورها، دستگاه‌های ذخیره‌سازی، و سوئیچ‌ها برای اتصال و مدیریت شبکه ذخیره‌سازی هستند.

    • چه زمانی باید از SAN استفاده کرد؟

    هنگامی که نیاز به دسترسی سریع، ایمن و پیوسته به داده‌ها در مقیاس بزرگ دارید، مانند مراکز داده و سازمان‌های بزرگ.

    • چه چالش‌هایی در استفاده از SAN وجود دارد؟  

    هزینه‌های پیاده‌سازی و نگهداری بالا، پیچیدگی فنی، و نیاز به مدیریت تخصصی از چالش‌های اصلی SAN هستند.


AI Chat